Глава 2. Геометрия: от линейной алгебры к SO(3)
Вторая лекция курса «3D компьютерное зрение и графика».
Глава держится на одной задаче: деталь отсканирована с двух сторон, и два облака точек нужно свести в одну систему координат. Каждый инструмент появляется в тот момент, когда задача в него упирается.
Это единственная глава курса, где ничего не реконструируется: облака точек нам даёт прибор. Пятнадцать недель мы восстанавливаем геометрию мира и ровно одну неделю приводим в порядок инструменты, которыми это делается.
Соглашения, действующие с первой формулы. Векторы — столбцы: $\mathbf{x}\in\mathbb{R}^3$ есть матрица $3\times1$, строка пишется явно как $\mathbf{x}^\top$. Матрица действует слева, $\mathbf{y}=A\mathbf{x}$, поэтому композиция читается справа налево: в $AB\mathbf{x}$ первым применяется $B$. Все системы координат — правые тройки, $\mathbf{e}_1\times\mathbf{e}_2=\mathbf{e}_3$. Знак $\sim$ читается как «равно с точностью до ненулевого множителя», тильда над вектором означает однородное представление.
2.1. Задача
2.1.1. Откуда берутся два облака точек
Деталь из главы 1 — клетка седла клапана — стоит на столе, вокруг неё водят оптический сканер. Сканер измеряет расстояние до того, что видит, и выдаёт облако точек: набор трёхмерных координат в своей собственной системе, привязанной к положению прибора.
Одного положения не хватает. Сканер видит только обращённую к нему сторону: всё, что за деталью, и всё, что внутри окна, остаётся неизмеренным. Для нашей детали один проход покрывает около сорока пяти процентов поверхности.
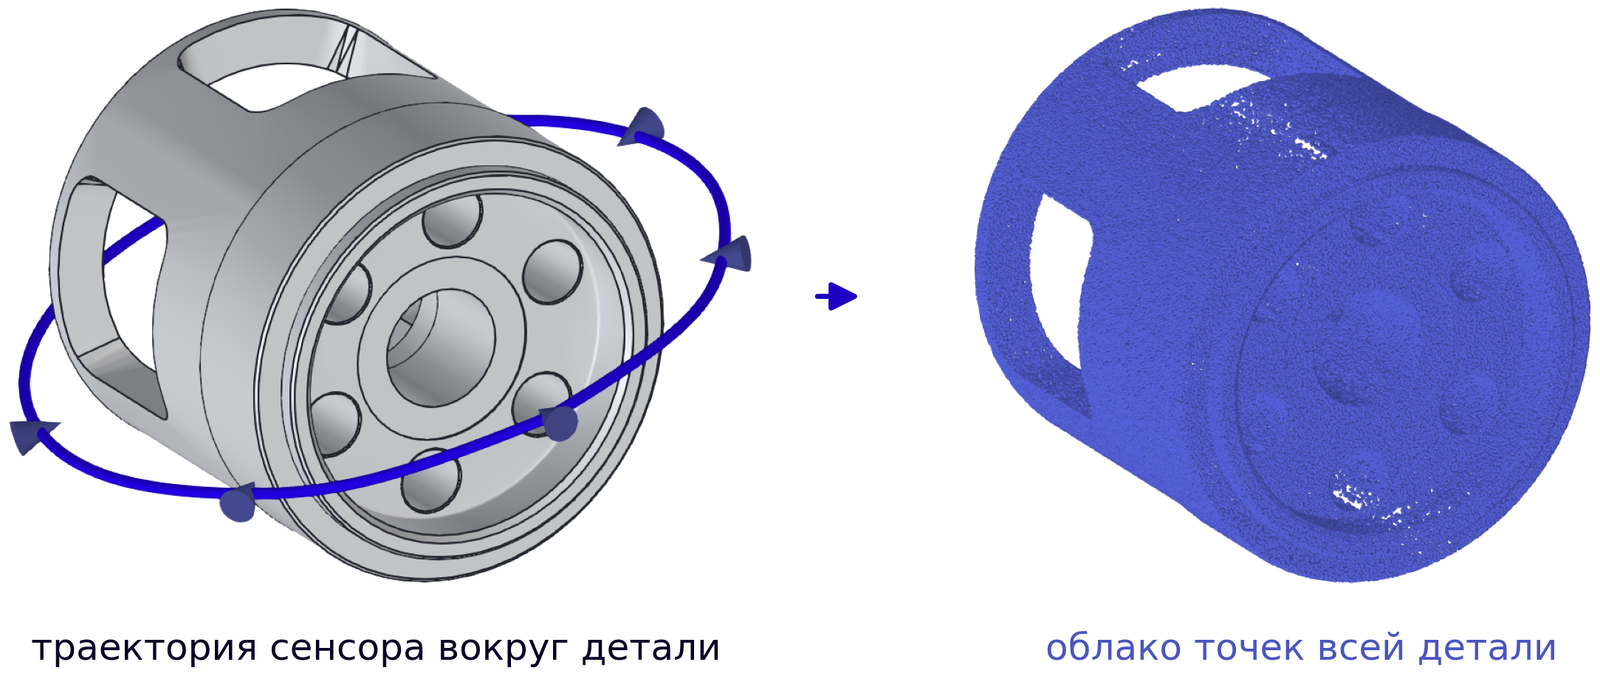
Значит, проходов нужно несколько. И вот тут возникает задача этой главы. Каждый проход даёт облако в своей системе координат: сканер не помнит, где деталь лежала минуту назад, и не знает, на сколько его самого переставили. Пока системы не совмещены, у нас не одна деталь, а четырнадцать несвязанных фрагментов, висящих под случайными углами друг к другу.
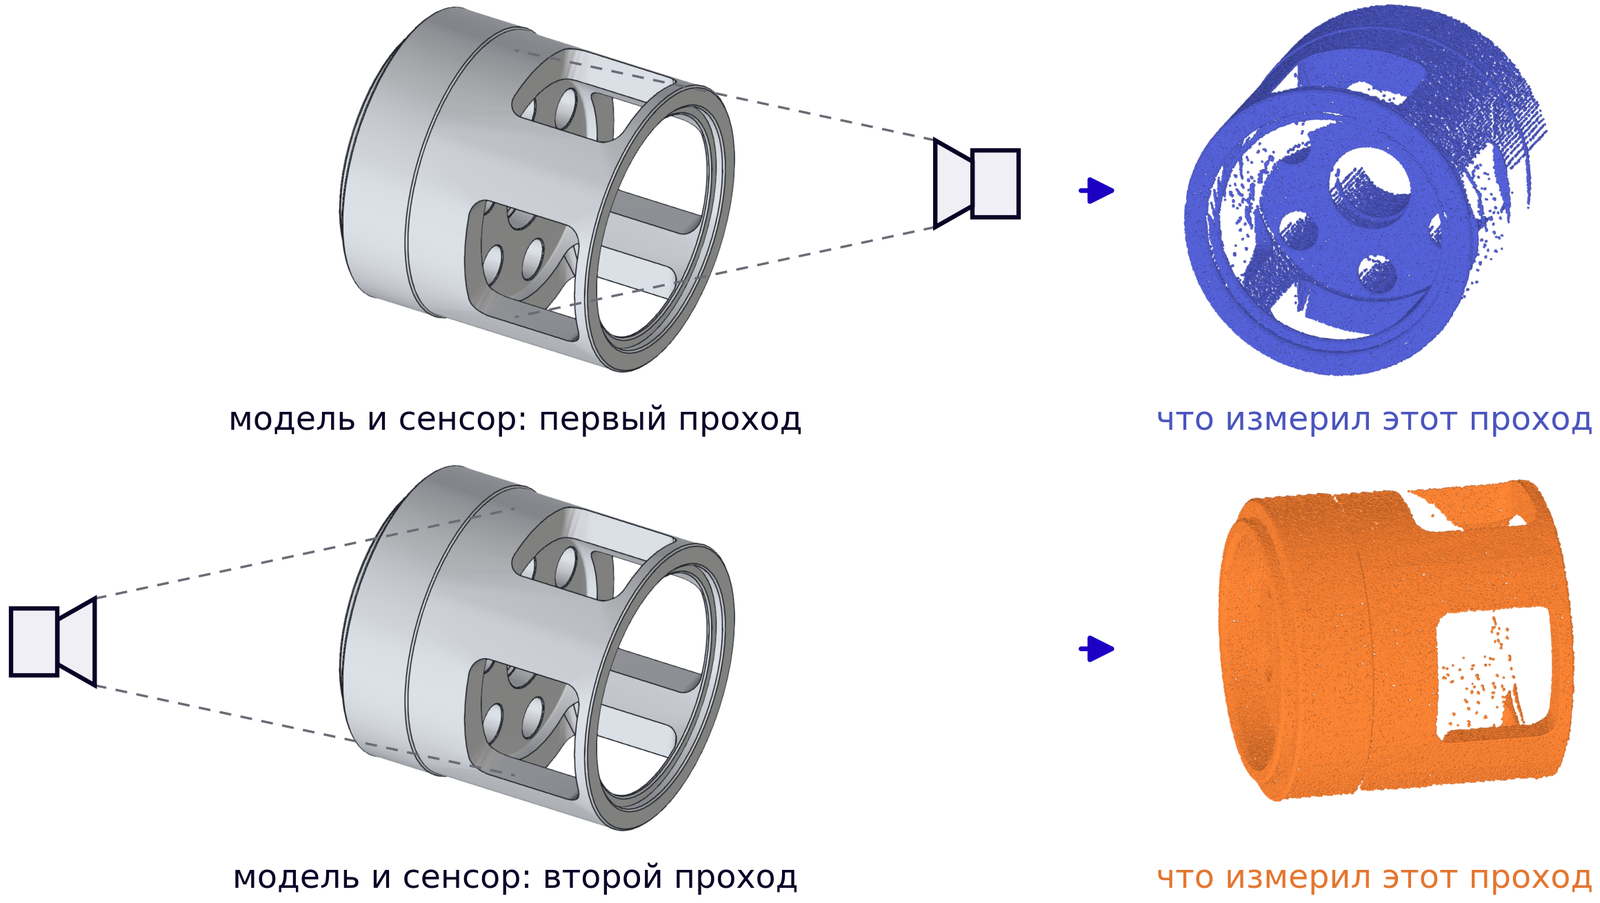
Перекрытие проходов — не случайность съёмки, а необходимое условие. Без общего куска два облака нечем связать: любое взаимное положение будет одинаково хорошо согласовано с данными, потому что данные про эту пару вообще ничего не говорят.
2.1.2. Что значит «совместить»
Дальше глава работает с двумя проходами; для четырнадцати всё то же самое, только неизвестных больше, и к этому мы вернёмся в § 2.6.7.
Совмещать есть по чему: на детали видны узнаваемые места, попавшие в оба скана, — углы прямоугольного окна, центры отверстий. Отметив их там и там, получаем пары. В каждой паре $(\mathbf{p}_i,\mathbf{q}_i)$ — координаты одной и той же физической точки: $\mathbf{p}_i$ в системе второго скана, $\mathbf{q}_i$ в системе первого.
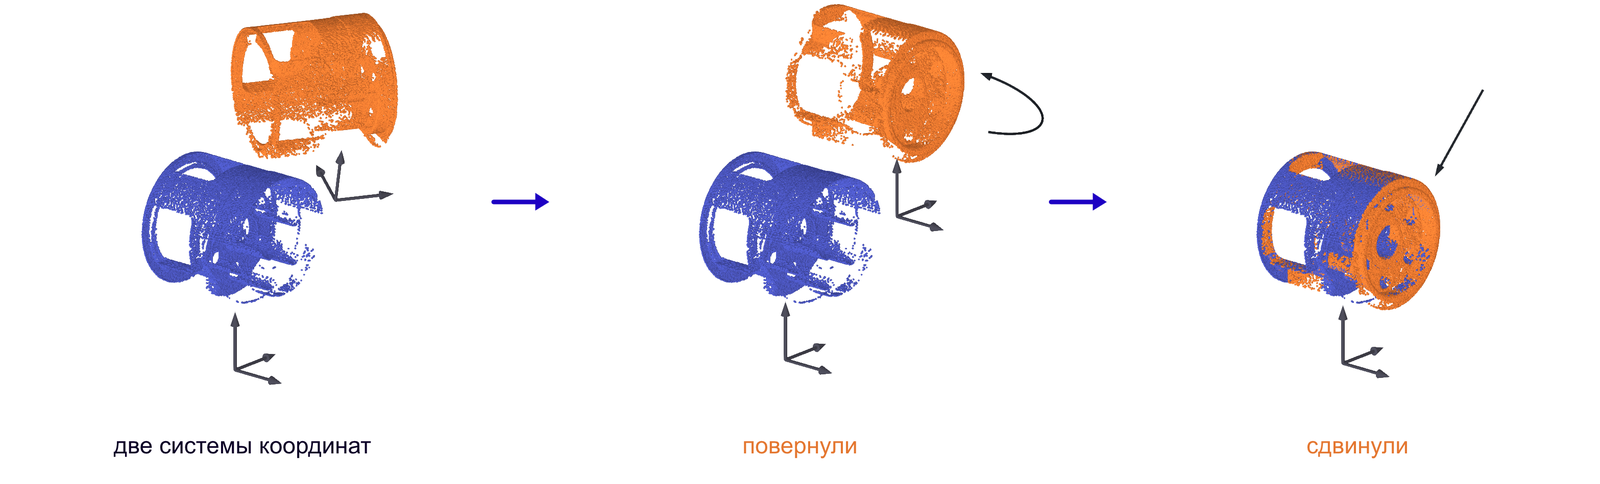
Отсюда формулировка: найти преобразование, которое кладёт второй скан в систему координат первого. Из рисунка видно, что оно раскладывается на две части, поворот $R$ и перенос $\mathbf{t}$, и действует как
$$ \mathbf{x}\;\longmapsto\;R\mathbf{x}\;\longmapsto\;R\mathbf{x}+\mathbf{t}. $$
2.1.3. Почему это считают, а не подгоняют мышкой
Совместить два облака можно руками в любом редакторе: подвигать, покрутить, глазом свести кромки. Соблазн реальный, и он неверен по двум причинам, и обе измеримы.
Первая — точность. Ошибка в один градус на радиусе нашей детали, а это 52 мм, даёт на кромке смещение 0,91 мм. Шум самого сканера — доли миллиметра. То есть глаз ошибается заметно сильнее, чем измеряет прибор, и вся точность, за которую заплачено оборудованием, теряется на последнем шаге.
Вторая — объём. Проходов четырнадцать, значит, совмещений тринадцать, и каждое надо будет повторить при следующем сканировании следующей детали. Ручная операция, повторяемая тринадцать раз на изделие, в производственный процесс не встраивается.
2.1.4. Какое преобразование мы ищем
Прежде чем искать, надо сказать, в каком классе. Мы будем искать поворот и перенос — и это не единственный мыслимый вариант, поэтому выбор надо обосновать.
Деталь между съёмками не менялась: её не грели, не гнули, не растворяли. Значит, расстояние между любыми двумя точками детали в первом скане и во втором одинаково.
Преобразования, сохраняющие все попарные расстояния, называются изометриями. Их ровно два сорта: повороты с переносами и те же повороты с переносами, но вдобавок с отражением. Сохранения расстояний мало, чтобы отбросить второй сорт, и это придётся сделать отдельным доводом: деталь не выворачивается наизнанку, то есть сохраняется ещё и ориентация. Изометрии, сохраняющие ориентацию, и называются жёсткими движениями — поворот и перенос.
Что из этого следует:
- Растяжение и скос запрещены сохранением расстояний: они означали бы, что деталь изменила размер или форму.
- Отражение расстояния сохраняет и запрещено только физикой. Математика его не запрещает, поэтому в § 2.3.8 нам придётся отдельно позаботиться о том, чтобы алгоритм его не выдал.
2.2. Чем записать движение
2.2.1. Три объекта: точка, поворот, сдвиг
В формуле $\mathbf{x}\mapsto R\mathbf{x}+\mathbf{t}$ три объекта, и из них только точка не требует пояснений. Разберём два оставшихся.
Перенос $\mathbf{t}\in\mathbb{R}^3$ — обычный вектор, три свободных числа, никаких ограничений.
Поворот $R$ — матрица $3\times3$, но не любая. Чтобы понять, какая, посмотрим на её столбцы. Первый столбец $R$ есть $R\mathbf{e}_1$, то есть образ первого базисного вектора; аналогично второй и третий. Значит, столбцы $R$ — это то, куда переехали оси исходной системы.
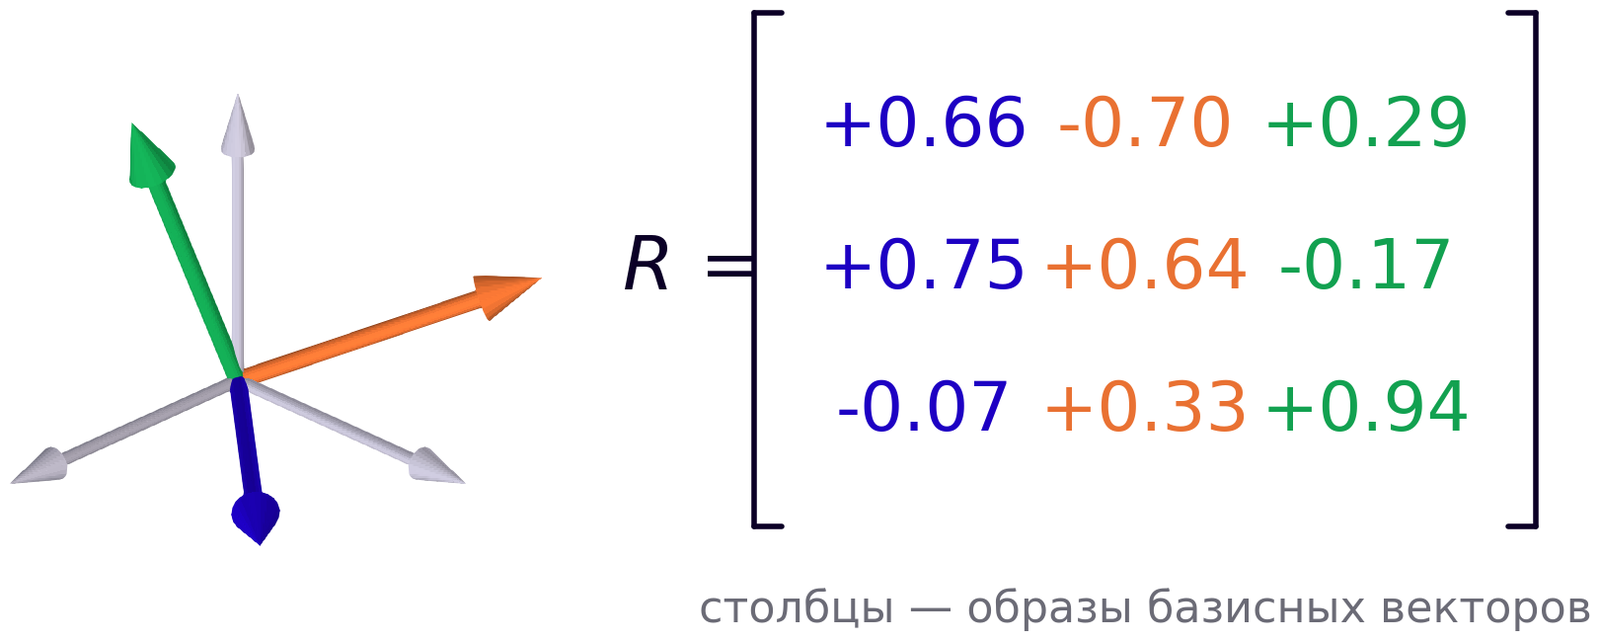
Отсюда читаются оба требования к $R$, и читаются как свойства этой новой тройки осей.
Оси остаются единичными и взаимно перпендикулярными. На языке матриц это ровно $R^\top R=I$: элемент $(i,j)$ произведения есть скалярное произведение $i$-го и $j$-го столбцов, и требование «единичные и перпендикулярные» означает единицы на диагонали и нули вне её. Матрицы с таким свойством называются ортогональными.
Тройка остаётся правой. Ортогональность этого не гарантирует: отражение тоже сохраняет длины и углы, но переводит правую тройку в левую. Различает их определитель: у поворота $\det R=+1$, у отражения $\det R=-1$.
Два требования вместе и задают матрицы поворота. Заметим сразу, чем мы за них заплатим: в $R$ девять чисел, а уравнений $R^\top R=I$ ровно шесть (три на единичность столбцов, три на попарную ортогональность), так что свободных параметров остаётся три. Девять чисел, связанных шестью уравнениями, — источник почти всех трудностей второй половины главы.
2.2.2. Поломка: перенос не линеен
Нам нужно не только применять движение, но и сцеплять: сначала второй скан в первый, потом первый в систему детали из CAD-модели. Первое желание — искать одну матрицу $3\times3$ на всё движение. Не выйдет: линейное отображение обязано переводить ноль в ноль, а $\mathbf{x}\mapsto\mathbf{x}+\mathbf{t}$ переводит ноль в $\mathbf{t}$. Матрицы $3\times3$ для жёсткого движения не существует.
Значит, приходится таскать пару $(R,\mathbf{t})$ и выводить правило композиции руками. Применим одно движение, потом второе:
$$ R_2\left(R_1\mathbf{x} + \mathbf{t}_1\right) + \mathbf{t}_2 = \underbrace{R_2R_1}_{R}\,\mathbf{x} + \underbrace{R_2\mathbf{t}_1 + \mathbf{t}_2}_{\mathbf{t}} . $$
Чтобы свернуть два движения в одно, вращения надо перемножить, а переносы — сначала повернуть первый вторым поворотом и только потом сложить. Внутри одного «сложения преобразований» оказались две разные операции, и отсюда ошибка, живущая в чужом коде дольше всего: $\mathbf{t}_1+\mathbf{t}_2$ без $R_2$. Ничего не падает, половинки детали почти сходятся, и подозрение падает на что угодно, кроме сложения двух векторов.
Хуже другое: у пары $(R,\mathbf{t})$ нет естественного типа данных. Обычное умножение для неё не определено, и чтобы композиция стала одной строкой кода, нужен свой класс со своим правилом и своим обращением, а цепочка из четырнадцати сканов — это тринадцать вложенных выражений, в каждом из которых теряется множитель.
Требование к аппарату формулируется точно: нужна запись, где перенос — часть матрицы, композиция — матричное умножение, обращение — обратная матрица.
2.2.3. Оба действия в одной матрице
Требование выполнимо, и приём стоит одной строки. Допишем к вектору координат четвёртую компоненту, равную единице, а к матрице поворота — четвёртый столбец, равный $\mathbf{t}$:
$$ \begin{pmatrix} R & \mathbf{t}\\ \mathbf{0}^\top & 1\end{pmatrix} \begin{pmatrix}\mathbf{x}\\ 1\end{pmatrix} =\begin{pmatrix} R\mathbf{x}+\mathbf{t}\\ 1\end{pmatrix}. $$
Проверьте умножением: первые три строки дают ровно $R\mathbf{x}+\mathbf{t}$, последняя даёт $1$, то есть результат снова годится на вход следующей такой матрице. Перенос стал частью линейной операции, потому что мы подняли размерность: сдвиг в трёхмерии — это скос в четырёхмерии.
Обозначим такую матрицу $T$. Композиция теперь просто произведение:
$$ T_2T_1=\begin{pmatrix} R_2R_1 & R_2\mathbf{t}_1+\mathbf{t}_2\\ \mathbf{0}^\top & 1\end{pmatrix}, $$
и в правом верхнем блоке само собой оказалось то самое $R_2\mathbf{t}_1+\mathbf{t}_2$, которое в § 2.2.2 приходилось помнить руками. Правило, которое было отдельным знанием, стало следствием умножения матриц.
Обращение тоже выписывается явно. Движение, обратное к «повернуть на $R$, сдвинуть на $\mathbf{t}$», — это «сдвинуть на $-\mathbf{t}$, повернуть на $R^\top$», причём в этом порядке:
$$ T^{-1}=\begin{pmatrix} R^\top & -R^\top\mathbf{t}\\ \mathbf{0}^\top & 1\end{pmatrix}. $$
Обратный перенос равен $-R^\top\mathbf{t}$, а не $-\mathbf{t}$: вектор сначала поворачивают. Проверяется умножением на $T$.
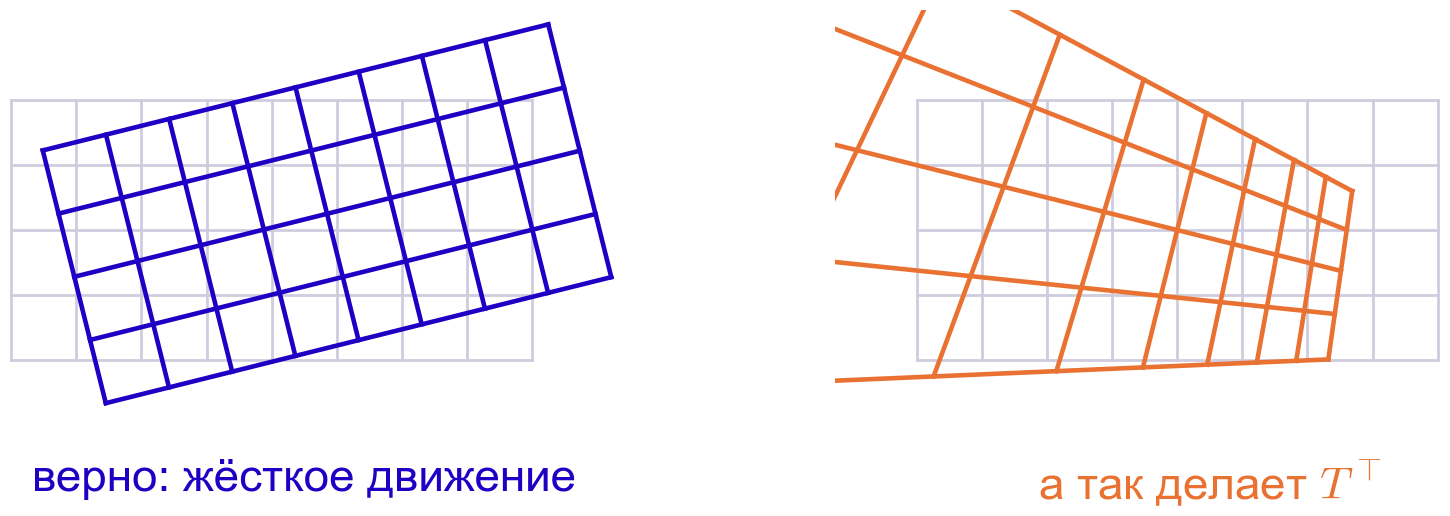
Ошибка, которая не падает. Раз $T$ собрана из блоков, а обращение поворота есть транспонирование, рука сама пишет T_inv = T.T. Посмотрите, что при этом происходит: столбец $\mathbf{t}$ уезжает в последнюю строку. Она перестаёт быть $(0,0,0,1)$, и у результата умножения последняя координата оказывается не единицей, а $1+\mathbf{t}^\top\mathbf{x}$. Жёсткое движение превратилось в проективное преобразование, а исключения не было.
2.2.4. Что означает приписанная единица
Приём работает, но пока это фокус. Разберёмся, что стоит за четвёртой координатой, потому что через неделю она понадобится нам всерьёз.
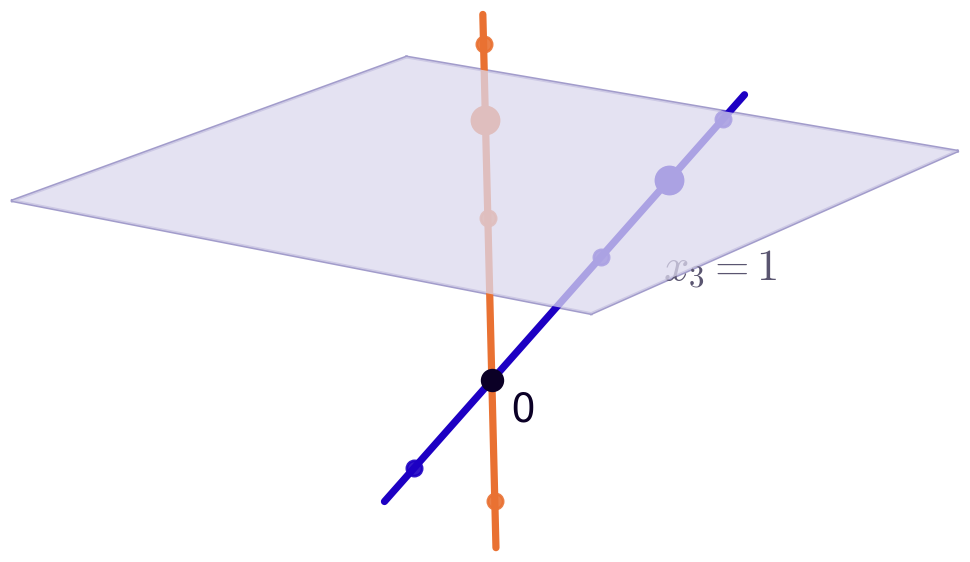
Вектор $(x_1,x_2,x_3,x_4)$ мы будем считать записью трёхмерной точки, и записью не единственной: умножение всех четырёх чисел на любое ненулевое $\lambda$ описывает ту же точку.
$$ \tilde{\mathbf{x}}\sim\lambda\tilde{\mathbf{x}},\qquad \lambda\neq0. $$
Это отношение эквивалентности: рефлексивно, симметрично, транзитивно. Класс эквивалентности — целая прямая через начало координат, из которой выколот сам ноль: вектор $(0,0,0,0)$ не задаёт никакой точки.
Обратный переход в трёхмерие — деление на последнюю координату:
$$ (x_1,x_2,x_3,x_4)\;\longmapsto\;\left(\frac{x_1}{x_4},\frac{x_2}{x_4},\frac{x_3}{x_4}\right),\qquad x_4\neq0. $$
Делить всегда можно, и условие $x_4\neq0$ здесь не оговорка: у точки последняя координата нулём не бывает по построению. Нулевой она бывает только у идеальных точек, о которых ниже.
Такие координаты называются однородными, а пространство классов — проективным. Приписанная единица, с которой мы начали, — это просто выбор удобного представителя.
2.2.5. К чему это приводит: та же матрица станет камерой
Мы разрешили деление на последнюю координату, но у жёсткого движения оно ни разу не срабатывает: последняя строка $(0,0,0,1)$ всегда возвращает единицу. Разрешённая операция стоит неиспользованной.
Посмотрим, что будет, если ею воспользоваться. Заменим последнюю строку на строку, считывающую глубину. Тогда последняя координата результата станет равной $Z$, а деление на неё — это в точности перспектива: то, что дальше, изображается мельче.
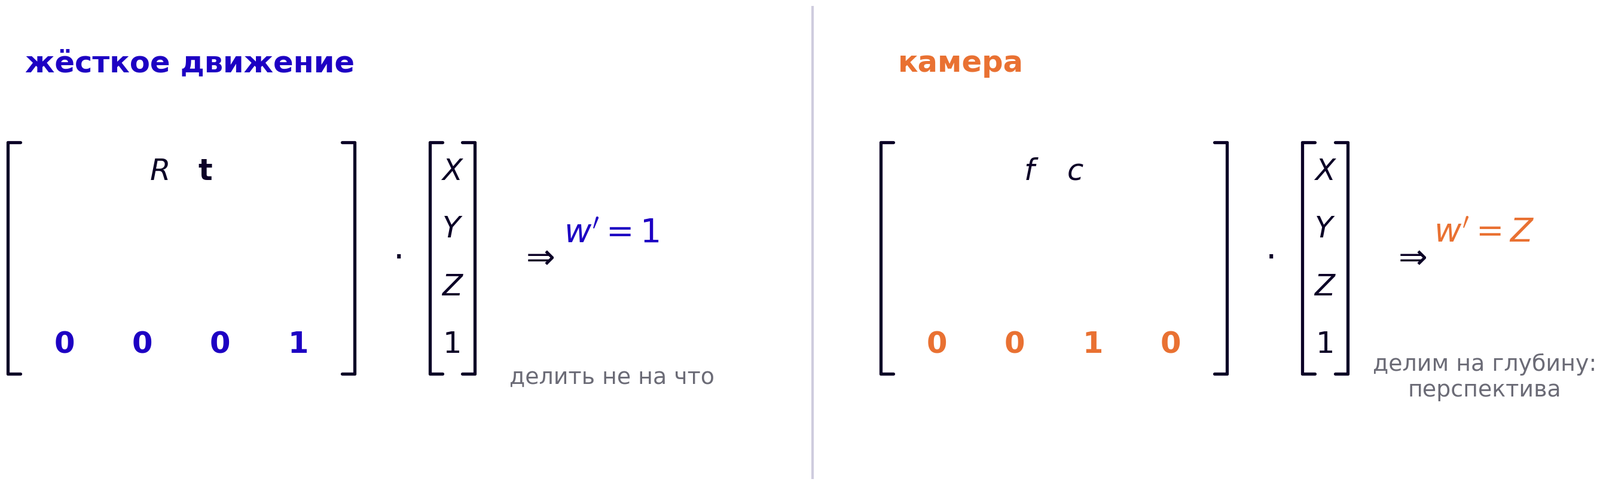
Отсюда же читается и то, почему параллельные прямые на снимке сходятся. У их точки пересечения последняя координата равна нулю: в трёхмерие такая точка не переводится, делить не на что. Это и есть идеальная точка, кодирующая направление, а не место. Камера переводит её в конечный пиксель — точку схода. Оговорка: не всякое направление даёт конечную точку схода. Направления, перпендикулярные оптической оси, остаются на бесконечности и на снимке параллельными.
И сразу уточним, чтобы не возникло ложного впечатления. Настоящая камера — это отображение из трёхмерия в двумерие, матрица $3\times4$, и размерность на ней теряется. Матрица $4\times4$ с непустой последней строкой, которую мы только что получили, — обратимое преобразование трёхмерного проективного пространства; именно в таком виде проекция живёт в графическом конвейере, где глубину ещё нужно сохранить для сортировки. Пиксель получается на следующем шаге, когда одну координату отбрасывают.
Сегодняшней задаче это не нужно, и дальше в главе мы этим не пользуемся. Но полдела для лекции 3 сделано: деление на последнюю координату, которое там понадобится, у нас уже есть.
2.2.6. $SO(3)$ и $SE(3)$: имена и степени свободы
Множество матриц поворота обозначается $SO(3)$, и имя расшифровывается по буквам.
- orthogonal — условие $R^\top R=I$: длины и углы сохраняются.
- special — условие $\det R=+1$: отражения исключены.
- (3) — размерность пространства, матрицы $3\times3$.
Множество матриц $T$ обозначается $SE(3)$, special Euclidean: движения евклидова пространства, то есть повороты и сдвиги.
Оба множества — группы: произведение двух элементов снова элемент, обратный элемент существует и тоже внутри, единица есть. Именно это и требовалось от аппарата в § 2.2.2.
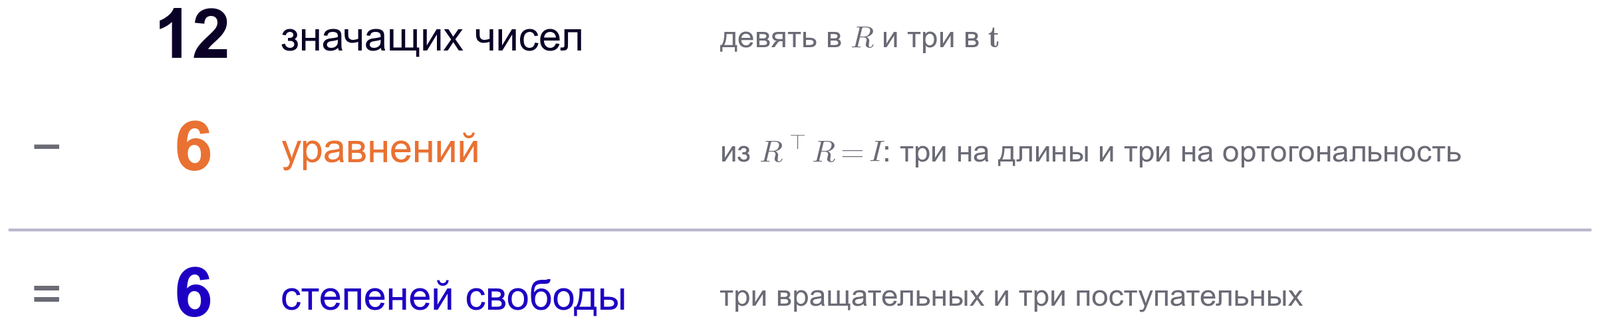
Посчитаем степени свободы $SE(3)$. В матрице $4\times4$ шестнадцать чисел, но последняя строка фиксирована, значит, значащих двенадцать: девять в $R$ и три в $\mathbf{t}$. Уравнений $R^\top R=I$ шесть. Остаётся шесть степеней свободы: три вращательных и три поступательных.
Определитель степеней свободы не отнимает: из ортогональности уже следует, что он равен $\pm1$, а знак дискретен и лишь выбирает одну из двух несвязных половин.
Итог: преобразование между двумя сканами — элемент $SE(3)$, шесть чисел, спрятанных в матрице $4\times4$. Записывать движение мы теперь умеем. Осталось не перепутать направление и научиться его находить.
2.2.7. Конвенции: где теряют часы
Скан выгружен, преобразование применено, половинки детали не сходятся: одна стоит вверх ногами, а окно у неё зеркально. Библиотека не сказала ни слова, и сказать ей нечего: и то, что вы подали, и то, что нужно было подать, — законные элементы $SE(3)$. Ошибка не в математике: одно слово обозначает две взаимно обратные матрицы, а одна матрица допускает две противоположные интерпретации.
Индексы читаются как единицы измерения. Пишите $T_{12}$ — «из системы 2 в систему 1», читая индексы справа налево: правый говорит откуда, левый куда. Композиция тогда проверяется на глаз сокращением соседних индексов:
$$ T_{13}=T_{12}\,T_{23},\qquad T_{21}=T_{12}^{-1}. $$
Внутренние индексы стоят рядом и сокращаются, как единицы в физической формуле; если в произведении оказались $T_{12}T_{12}$, вы ошиблись, ещё не запустив код. Дисциплина дешёвая, а целый класс ошибок из отладочных становится синтаксическим.
Направление: что лежит в файле. Одна и та же матрица зовётся то «позой», то «матрицей вида». $T_{wc}$ (из сенсора в мир) имеет последним столбцом положение сенсора в мире, а её столбцы — оси сенсора в мировых координатах. Обратная $T_{cw}$ переводит мировые точки в систему сенсора, и её перенос центром не является: центр равен $\mathbf{C}=-R^\top\mathbf{t}$ — то же обращение из § 2.2.3. «Естественной» конвенции нет: COLMAP отдаёт $T_{cw}$, transforms.json из nerfstudio — $T_{wc}$, cv2.solvePnP — вообще позу объекта относительно сенсора. Что у вас в руках, выясняется быстрее, чем читается документация: умножьте матрицу на $(0,0,0,1)^\top$ и посмотрите на образ начала координат — это её последний столбец.
Важно, как читать результат. По длине переноса конвенции не различить: $\mathbf{t}_{cw}=-R_{cw}\mathbf{t}_{wc}$, поэтому $\|\mathbf{t}_{cw}\|=\|\mathbf{t}_{wc}\|$ тождественно, и на круговом обходе обе серии дадут одинаковые числа. Различает направление. У $T_{wc}$ переносы — это положения сенсора вокруг детали: они смотрят в разные стороны, и их среднее близко к нулю. У $T_{cw}$ перенос — это начало мира в системе сенсора: у всех кадров он покомпонентно почти один и тот же и лежит вдоль оптической оси, примерно $(0,0,d)$.
И оговорка, без которой тест бесполезен: сам по себе образ начала координат смысла не устанавливает. Он подтверждает конвенцию, которую вы уже прочитали в спецификации формата, или отличает её от обратной, когда известен хотя бы один физический ориентир — центр сенсора, контрольная точка, направление взгляда.
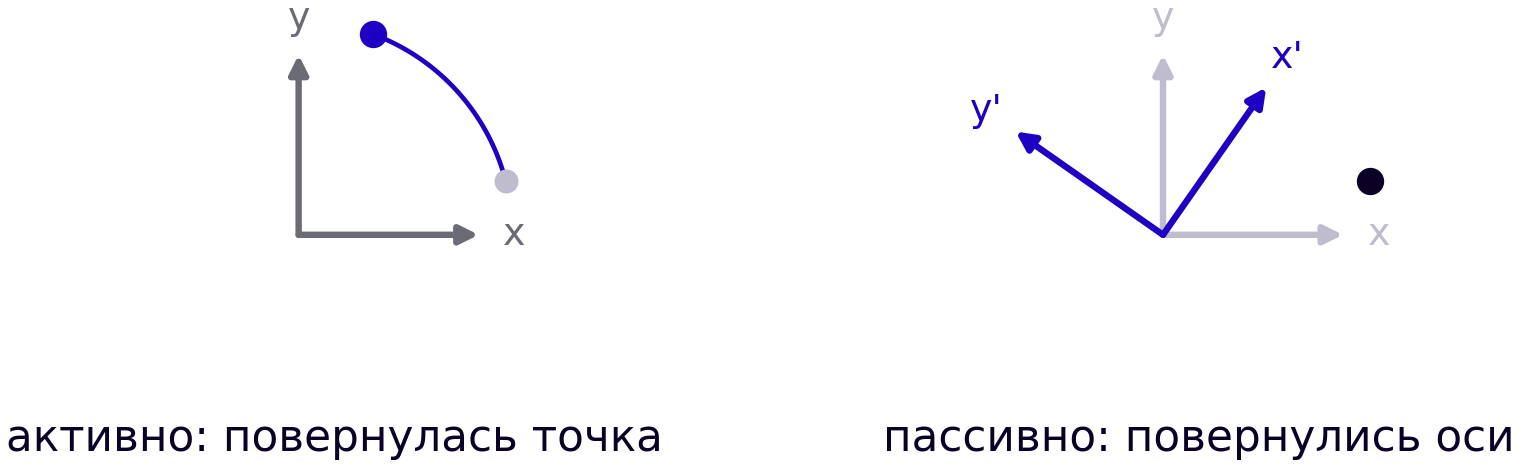
Активная и пассивная интерпретация. Активно: точка физически повернулась, $\mathbf{p}'=R\mathbf{p}$, оси не тронуты. Пассивно: точка на месте, а мы пересчитали её координаты в новый базис, и если столбцы $R$ — оси новой системы в старой, то переход к новым координатам есть умножение на $R^\top$. Активная и пассивная записи отличаются транспонированием, обе законны, и никто не скажет, какая перед вами: Rotation.from_euler в scipy строит активный поворот, а те же углы из паспорта сенсора обычно пассивны. Симптом — деталь вращается в правильной плоскости, но в обратную сторону: при малых углах незаметно, при больших очевидно.
Порядок умножения. У нас векторы-столбцы и действие слева, значит $T_2T_1$ — «сначала $T_1$». Часть графических экосистем (DirectX, PyTorch3D) держит векторы строками и пишет $\mathbf{p}'=\mathbf{p}M$: там все матрицы транспонированы, а порядок множителей обратный. Отдельный вопрос — раскладка в памяти: glTF и OpenGL хранят матрицу по столбцам, и чтение шестнадцати чисел построчно даёт транспонированную матрицу. Признак обоих случаев один: в последней строке рядом с единицей вместо нулей три числа, похожие на перенос.
Куда смотрят оси. В изображении номер строки растёт вниз, поэтому в OpenCV ось $y$ смотрит вниз, а $z$ вперёд; в OpenGL и Blender $y$ вверх, а $z$ назад. Обе тройки правые, переход между ними — умножение на $M=\operatorname{diag}(1,-1,-1)$: у матрицы camera→world меняют знак второй и третий столбцы, у world→camera — вторая и третья строки. Вот почему на такую ошибку не срабатывает ни одна проверка: $\det M=+1$ и $M^\top M=I$, то есть $M$ — законное вращение на $180^\circ$ вокруг оси $x$. Тесты на ортогональность и на определитель его пропустят, расстояния сохранятся; единственный признак — что деталь стоит вверх ногами. Если же сменить знак у одной оси (левая тройка, как в Unity), определитель станет $-1$, и это уже отражение: скан зеркален, обход вершин у треугольников сменился, и при отсечении задних граней модель исчезает. Отсюда чтение симптома: пропала или «дырявая» — нечётное число флипов осей; перевёрнутая, но целая — чётное.
Рецепт, когда сканы не сходятся. Три пункта, в этом порядке, до всякой отладки алгоритма.
- Прогоните через преобразование три пробных объекта: начало координат (куда переехал ноль — это сразу отличает $T_{12}$ от $T_{21}$), три единичных орта и одну точку детали, положение которой вы знаете физически.
- Проверьте матрицу тремя строками кода: $\|R^\top R-I\|<\varepsilon$, $\det R>0$, последняя строка равна $(0,0,0,1)$. $\det R\approx-1$ — отражение, ищите одиночный флип оси. $R^\top R\neq I$ — потерялось транспонирование, вкрался масштаб или матрица прочитана не в том порядке. Сломалась последняя строка — вы транспонировали всю $T$ целиком.
- Отлаживайтесь на несимметричном объекте и на большом повороте. Куб и поворот на $5^\circ$ спрячут и зеркальность, и перепутанный знак; клетка клапана с окном на боку, повёрнутая на $40^\circ$, покажет всё сразу. И держите направление в имени переменной:
T_scan1_scan2, а неpose.
Если все три пункта пройдены, а сканы не сходятся, дело уже не в конвенциях: значит, преобразование у нас неверное, и пора его наконец вычислить.
2.3. Как найти преобразование по парам точек
2.3.1. Данные
Мы знаем, чем записывается совмещение, и знаем, в какую сторону оно действует. Осталось найти $R$ и $\mathbf{t}$, а данные для этого уже есть: пары $(\mathbf{p}_i,\mathbf{q}_i)$ из § 2.1.2.
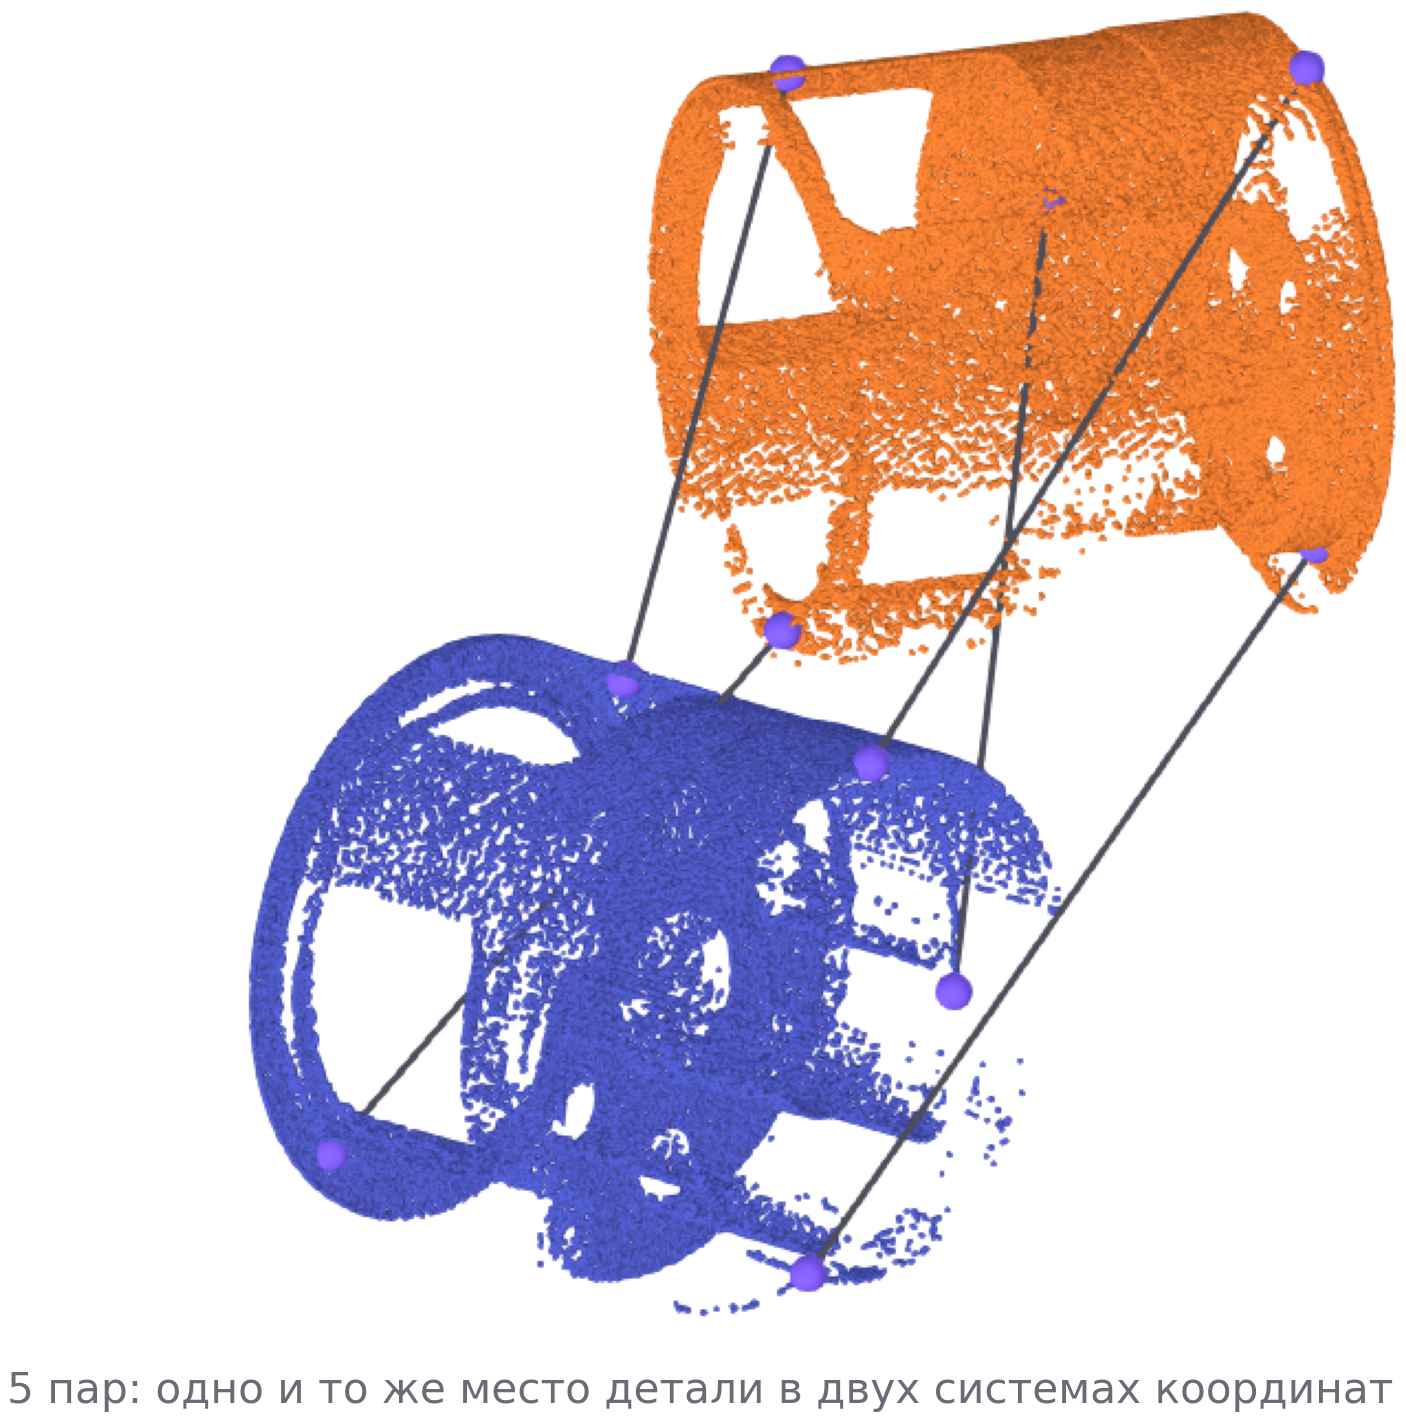
«Лучше всего» теперь означает конкретное: минимум суммы квадратов длин этих отрезков. Неизвестных шесть. Минимум по сдвигу взять несложно, это свободный вектор. А вот $R$ обязана быть поворотом: девять чисел, связанных шестью уравнениями, — и как минимизировать по такому множеству, пока непонятно.
Откуда берутся сами пары, мы здесь не разбираем: их либо отмечают руками, либо ищут автоматически по локальным дескрипторам. Это тема лекции 4. Пока считаем, что пары даны.
2.3.2. Поломка: если искать произвольную матрицу
Самый естественный ход в такой ситуации — про ограничение забыть и искать вместо поворота произвольную матрицу $M$. Перенос при этом никуда не девается, поэтому сравнивать надо одинаковые задачи: минимизируем $\sum_i\|M\mathbf{p}_i+\mathbf{t}-\mathbf{q}_i\|^2$ по $M$ и $\mathbf{t}$ сразу.
Производная по $\mathbf{t}$ даёт то же, что и в § 2.3.3: оптимальный перенос совмещает центроиды, $\mathbf{t}=\bar{\mathbf{q}}-M\bar{\mathbf{p}}$. Подставив его обратно, получаем задачу для центрированных облаков, и она решается одной строкой:
$$ M=\Big(\sum_i\tilde{\mathbf{q}}_i\tilde{\mathbf{p}}_i^\top\Big)\Big(\sum_i\tilde{\mathbf{p}}_i\tilde{\mathbf{p}}_i^\top\Big)^{-1}, $$
при условии, что вторая матрица обратима, то есть точки не лежат на одной прямой.
Невязка при этом честно меньше, чем у любого настоящего поворота: минимум по всем матрицам не может быть больше минимума по подмножеству вращений. И именно поэтому ответ неверен. Свободная матрица использует лишние степени свободы, чтобы подогнаться под шум: у найденной $M$ оказывается $M^\top M\neq I$, то есть она не только поворачивает деталь, но и слегка растягивает и скашивает её. Окно перестаёт быть прямоугольным, отверстия — круглыми.
Вывод: ограничение $R\in SO(3)$ надо учитывать в самой постановке, а не чинить результат потом.
2.3.3. Шаг первый: перенос уходит центрированием
Правильная постановка называется задачей Прокруста, её решение — алгоритм Кабша (Kabsch, 1976; независимо Arun et al., 1987):
$$ E(R,\mathbf{t})=\sum_{i}\big\|R\mathbf{p}_i+\mathbf{t}-\mathbf{q}_i\big\|^2\to\min, \qquad R\in SO(3). $$
Ограничение стоит прямо в постановке, а не приделано сбоку.
На $\mathbf{t}$ ограничений нет, поэтому приравняем производную по нему нулю:
$$ \frac{\partial E}{\partial\mathbf{t}}=2\sum_i\left(R\mathbf{p}_i+\mathbf{t}-\mathbf{q}_i\right)=0 \qquad\Longrightarrow\qquad \mathbf{t}=\bar{\mathbf{q}}-R\bar{\mathbf{p}}, $$
где $\bar{\mathbf{p}}$ и $\bar{\mathbf{q}}$ — центроиды наборов. Прочитайте это вслух: при любом повороте оптимальный сдвиг просто совмещает центры масс. Это не приближение и не эвристика, а точное условие оптимальности, верное для каждого $R$.
Подставим найденное $\mathbf{t}$ обратно. Внутри нормы окажется $R\mathbf{p}_i+\bar{\mathbf{q}}-R\bar{\mathbf{p}}-\mathbf{q}_i$; сгруппировав, получаем
$$ E(R)=\sum_i\big\|R\tilde{\mathbf{p}}_i-\tilde{\mathbf{q}}_i\big\|^2, \qquad \tilde{\mathbf{p}}_i=\mathbf{p}_i-\bar{\mathbf{p}},\quad \tilde{\mathbf{q}}_i=\mathbf{q}_i-\bar{\mathbf{q}}. $$
Та же задача, но без переноса: одна неизвестная вместо двух, и она под ограничением. Центрирование алгоритм делает сам, никакой предварительной подготовки данных для этого не нужно.
2.3.4. Шаг второй: расстояния превращаются в след
Раскроем квадрат нормы разности:
$$ E(R)=\sum_i\|\tilde{\mathbf{p}}_i\|^2+\sum_i\|\tilde{\mathbf{q}}_i\|^2 -2\sum_i\tilde{\mathbf{q}}_i^\top R\,\tilde{\mathbf{p}}_i . $$
Первое слагаемое уже упрощено: $\|R\tilde{\mathbf{p}}\|^2=\tilde{\mathbf{p}}^\top R^\top R\tilde{\mathbf{p}}=\|\tilde{\mathbf{p}}\|^2$, потому что $R$ ортогональна. Это и есть содержательный смысл условия $R^\top R=I$. Второе слагаемое от $R$ не зависит очевидно. Значит, от поворота зависит только третье, и минимизировать разность с минусом — то же самое, что максимизировать саму сумму.
Дальше приём, ради которого всё затевалось. Скалярное произведение — число, а число равно следу матрицы $1\times1$; след цикличен, поэтому сомножители можно прокрутить по кругу. Прокрутив и вынеся сумму внутрь:
$$ \sum_i\tilde{\mathbf{q}}_i^\top R\,\tilde{\mathbf{p}}_i=\operatorname{tr}\!\left(R^\top H\right)\;\longrightarrow\;\max, \qquad H=\sum_i\tilde{\mathbf{q}}_i\tilde{\mathbf{p}}_i^\top . $$
Матрица $H$ называется кросс-ковариацией двух центрированных облаков. Обратите внимание, что произошло: вся информация о взаимной ориентации сканов, сколько бы точек мы ни взяли, сто или сто тысяч, улеглась в девять чисел. Сами точки дальше не нужны.
И вот где мы оказались. След $\operatorname{tr}(R^\top H)$ линеен по $R$ — это просто сумма произведений элементов. Но максимизировать его надо не по всему пространству матриц, а по множеству поворотов, а оно кривое. К тому же $H$ собрана из измерений: ортогональной она не будет, определитель у неё какой угодно. Это произвольная матрица $3\times3$, а ответ нам нужен в виде поворота.
Значит, придётся разобраться, что произвольная матрица вообще делает с пространством.
2.3.5. Что умеет произвольная матрица
Ответ: всего три вещи, и всегда в одном порядке.
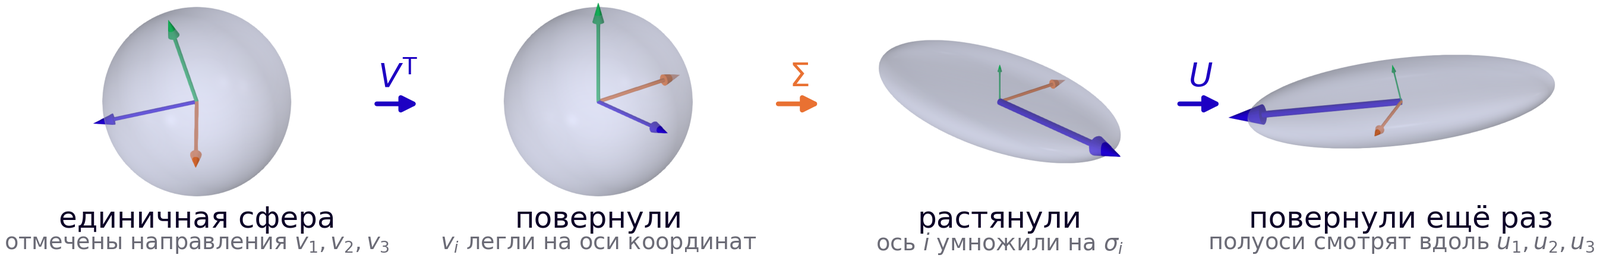
Разберём кадры. Первый: единичная сфера, на ней отмечены три взаимно перпендикулярных направления. Второй: подействовали ортогональной матрицей $V^\top$ — сфера осталась сферой, но отмеченные направления легли ровно на оси координат; именно за этим $V$ и нужна. Третий: подействовали диагональной $\Sigma$, а диагональная матрица умеет ровно одно — растянуть каждую ось в своё число раз; сфера стала эллипсоидом с осями вдоль координатных. Четвёртый: подействовали ортогональной $U$, эллипсоид повернулся как жёсткое тело.
Собирая, получаем сингулярное разложение:
$$ A=U\Sigma V^\top,\qquad \Sigma=\operatorname{diag}(\sigma_1\ge\sigma_2\ge\dots\ge0). $$
Числа $\sigma_i$ называются сингулярными, столбцы $U$ и $V$ — левыми и правыми сингулярными векторами. Разложение существует для любой вещественной матрицы, в том числе прямоугольной.
Одна оговорка, без которой утверждение неверно. Матрицы $U$ и $V$ ортогональны, а ортогональные бывают двух сортов. Сигмы неотрицательны, поэтому знак определителя $A$ целиком лежит на $U$ и $V$: если $\det A<0$, ровно один из множителей оказывается отражением. Проверьте на $\operatorname{diag}(1,1,-1)$: двумя поворотами и неотрицательным растяжением её не собрать. Через два раздела на этом будет построена ловушка.
2.3.6. Что видно по сингулярным числам
Вся картинка предыдущего раздела сворачивается в одну строку:
$$ A\mathbf{v}_i=\sigma_i\mathbf{u}_i, \qquad |\det A|=\sigma_1\sigma_2\sigma_3 . $$
Проверьте по кадрам: $\mathbf{v}_i$ стоял на сфере, стал полуосью длины $\sigma_i$, смотрящей вдоль $\mathbf{u}_i$. Отсюда читаются три рабочих показания.
Ранг — число ненулевых $\sigma_i$, то есть сколько у эллипсоида настоящих измерений. Одно нулевое — эллипсоид сплющился в плоский диск, два нулевых — в отрезок.
Почти-ядро. На практике нули не встречаются: измерения зашумлены, и вместо нуля вы увидите очень маленькое $\sigma$. Направление $\mathbf{v}$ при наименьшем $\sigma$ — то, которое матрица почти уничтожает.
Обусловленность $\sigma_1/\sigma_n$ — насколько эллипсоид вытянут. Читать её надо как инженерное правило: числа с плавающей точкой двойной точности хранят около шестнадцати значащих десятичных цифр, поэтому обусловленность $10^k$ означает, что в ответе верны только $16-k$ из них.
И почему для этого не годится определитель, который вроде бы про то же самое. Определитель вырожденность не измеряет: умножьте матрицу $3\times3$ на сто, и он вырастет в миллион раз, хотя геометрически ничего не изменилось — эллипсоид стал больше, но не площе. Сингулярные числа вырастут ровно в сто раз каждое, а их отношение не изменится.
Заодно отметим то, что понадобится в § 2.3.8. Объём эллипсоида — произведение полуосей, поэтому модуль определителя равен произведению сингулярных чисел. Модуль здесь не опечатка: $\sigma_i$ неотрицательны по определению и знака не помнят. Разложение видит, во сколько раз матрица меняет объём, но не видит, переворачивает ли она ориентацию.
2.3.7. Шаг третий: максимум следа даёт поворот
Осталось максимизировать $\operatorname{tr}(R^\top H)$ по всем поворотам. Теперь мы умеем: подставим $H=U\Sigma V^\top$.
Прокрутим след ещё раз и соберём всё, что не $\Sigma$, в одну матрицу $M=V^\top R^\top U$. Она ортогональна как произведение ортогональных.
Здесь нужен один аккуратный шаг, который легко проскочить. Пока $R$ пробегает только повороты, определитель $M$ фиксирован: он равен $\det(UV^\top)$ и меняться не может. Поэтому сначала ослабим ограничение: поищем максимум по всем ортогональным $R$, то есть позволим $M$ пробегать всю ортогональную группу. Полученная оценка будет верна и для поворотов, а если максимум окажется достигнут на повороте, то он и есть ответ исходной задачи. Если не окажется — разберёмся отдельно, и это § 2.3.8.
Итак, для произвольной ортогональной $M$
$$ \operatorname{tr}\!\left(R^\top U\Sigma V^\top\right)=\operatorname{tr}(\Sigma M)=\sum_i\sigma_i m_{ii}\;\le\;\sigma_1+\sigma_2+\sigma_3 . $$
Неравенство следует из двух фактов, оба уже есть. Диагональный элемент ортогональной матрицы по модулю не больше единицы: столбец единичной длины, значит, любая отдельная его компонента не превосходит единицы. И $\sigma_i$ неотрицательны.
Оценка достижима. Равенство требует $m_{ii}=1$ для каждого $i$ с $\sigma_i>0$: слагаемые с нулевым $\sigma_i$ в сумму не входят, и соответствующие $m_{ii}$ на значение следа не влияют. А у ортогональной матрицы компонента единичного столбца равна единице только тогда, когда остальные нули.
Значит, при всех трёх $\sigma_i>0$ получается $M=I$ и решение единственно. Если же какое-то $\sigma_i$ равно нулю, соответствующее направление след не видит, и максимум достигается на целом семействе ортогональных $M$ — из него мы выберем одну матрицу в § 2.3.8. В обоих случаях $M=I$ допустимо, и
$$ M=I\;\Longrightarrow\;R^\top=VU^\top\;\Longrightarrow\;R=UV^\top, \qquad \mathbf{t}=\bar{\mathbf{q}}-R\bar{\mathbf{p}}. $$
Подведём итог. Чтобы совместить два скана, достаточно центрировать оба облака, посчитать одну матрицу $3\times3$ и одно сингулярное разложение от неё. Ни итераций, ни начального приближения, ни шага обучения, ни критерия остановки. Стоит понимать, за счёт чего так вышло: ограничение оказалось не помехой, а тем, что задачу решило.
2.3.8. Ловушка: знак определителя
Формула $R=UV^\top$ максимизирует след по всем ортогональным матрицам, а не только по поворотам. Про то, что ортогональные бывают двух сортов, мы предупредили в § 2.3.5; вот где это выстреливает.
Если $\det(UV^\top)=-1$, алгоритм вернёт отражение. Оно «идеально» совместит сканы, вывернув деталь наизнанку: нормали посмотрят внутрь, фаска окна окажется с другой стороны. Невязка при этом останется маленькой, ортогональность выполнена, и ни одна проверка не сработает. Починка обязательна:
$$ R=U\,\operatorname{diag}\!\big(1,\,1,\,\det(UV^\top)\big)\,V^\top . $$
Она берётся из той же выкладки: условие $\det R=+1$ переводится в условие на $\det M$. Если он равен $+1$, ничего не меняется. Если $-1$, то $M=I$ запрещена, и лучшее допустимое — $\operatorname{diag}(1,1,-1)$. След при этом падает на $2\sigma_3$, то есть мы жертвуем наименьшим из трёх сингулярных чисел, и это самая дешёвая из возможных жертв.
Теперь о том, когда $\det(UV^\top)$ действительно выходит отрицательным, потому что здесь легко сказать лишнего.
Плоскость сама по себе не беда. Если отмеченные точки лежат в одной плоскости, но не на одной прямой, поворот определён однозначно: две независимые разности задают третье направление векторным произведением. У $H$ при этом $\sigma_3=0$, и знак $\det(UV^\top)$ может выйти любым, но поправка его чинит, и ответ получается точным. Проверьте на квадрате из четырёх точек: спектр $H$ равен $(1,1,0)$, а восстановленный поворот совпадает с истинным до машинной точности. Так что совет «не отмечайте точки на одной грани» был бы неверен.
Беда — коллинеарность и теснота. Если точки лежат на одной прямой, нулевых сингулярных чисел два, и поворот вокруг этой прямой данными не определён вовсе: поправка выберет из семейства решений одно, но оснований предпочесть его нет. Второй случай — точки разнесены плохо: сингулярные числа не нули, но малы, и шум разворачивает ответ тем сильнее, чем теснее группа. Это уже не про знак, а про обусловленность.
Для нашей детали второй случай реален. Пять узнаваемых мест на торцевом фланце укладываются в слой толщиной 0,22 мм при детали в 100 мм, то есть третье направление держится почти на одном шуме. Те же пять точек, разнесённые по всей детали, дают слой в 30 мм.
Отсюда практический вывод: разносите отмеченные точки по детали как можно шире и следите, чтобы они не выстраивались вдоль прямой. Проверяйте знак всегда, это одна строка, и смотрите на $\sigma_3$: близость к нулю говорит не о неверном ответе, а о том, что третье направление держится на малом числе.
2.3.9. Что получилось и чего не хватает
Для точных соответствий задача решена в замкнутой форме: трёх пар хватает, чтобы получить $R$ и $\mathbf{t}$.
Но посмотрим, чего этот ответ не умеет. Я взял скан нашей детали, отметил на нём пять пар и посчитал Кабша три раза.
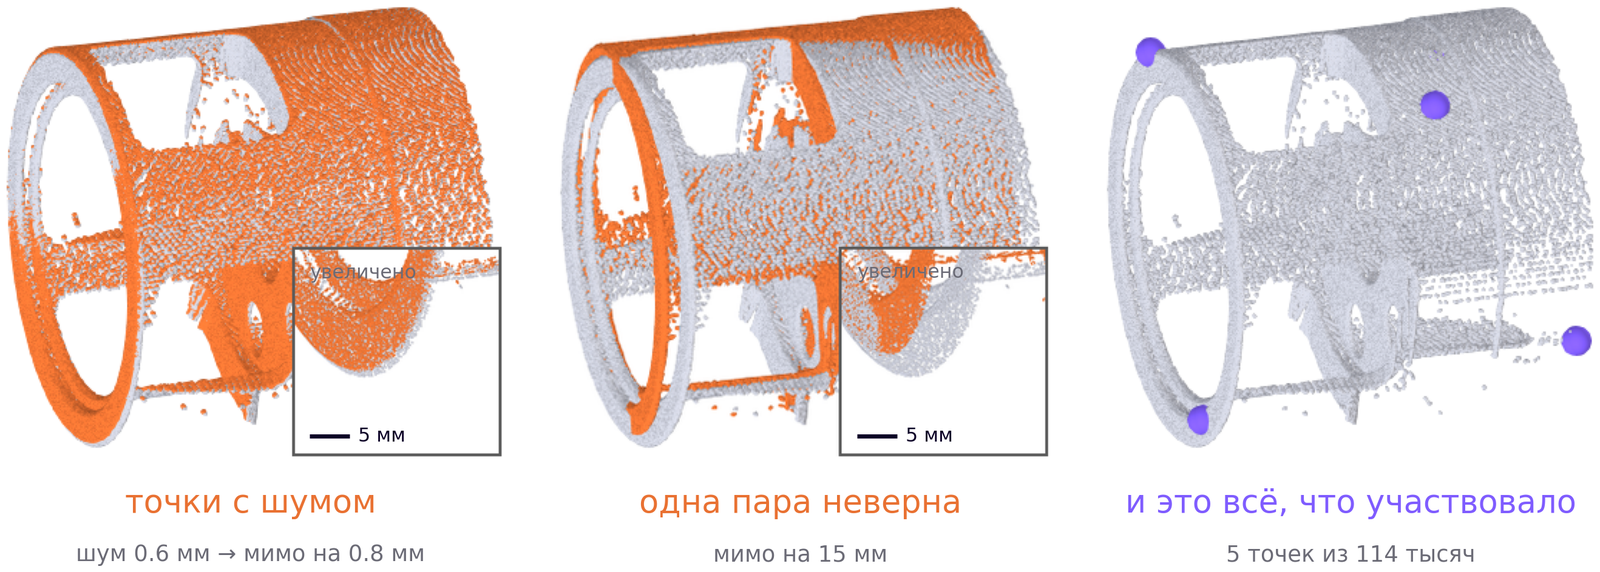
Три беды, и все три измеримы.
Шум. Пять точек его не усредняют: промах остаётся того же порядка, что и сам шум, около полумиллиметра по медиане.
Неверные пары. Одна грубая ошибка среди пяти утягивает решение на полтора сантиметра, потому что квадратичная потеря даёт большому промаху большой вес.
Неиспользованные измерения. В оценке участвовали пять точек из ста пятнадцати тысяч.
Решение надо уточнять — малыми шагами по всему облаку сразу. А это уже другая задача, и решается она не той математикой.
2.4. Какую задачу мы решаем дальше
2.4.1. Почему итерация лечит именно эти три беды
Прежде чем менять математику, разберём, почему итерация вообще отвечает на три беды из § 2.3.9. По одной.
Шум. Пять точек шум не усредняют. Лекарство известно из статистики: взять больше измерений, погрешность оценки падает примерно как корень из их числа. Сто тысяч точек вместо пяти — это более чем в сто раз меньший разброс. Но чтобы использовать сто тысяч точек, для каждой нужна пара, а пар нам никто не размечал.
Отсюда первое изменение: пары назначаем сами, ближайшим соседом. И вот здесь появляется итерация, причём не по выбору, а по необходимости. Ближайший сосед зависит от того, где сейчас стоит скан: сдвинули — и пары стали другими. Пока скан стоит неправильно, соседи назначены неправильно. Круг разрывается только так: грубо совместили, пересчитали соседей, снова совместили.
Неверные пары. Просто взять больше точек мало. Среди ста тысяч назначенных соседей часть будет назначена неверно, особенно на первых итерациях и там, где сканы не перекрываются. Квадратичная потеря даёт такой ошибке тем больший вес, чем она больше, и одна грубая пара утягивает всё — это мы видели на рис. 2.13. Значит, потерю надо менять.
Что именно считать промахом. Третье изменение менее очевидно. Даже при верных соседях мерить расстояние до самой точки соседа неправильно: скан — это поверхность, а точки на ней легли случайно.
2.4.2. Невязка: до точки или до поверхности
Сканер положил точки туда, куда легли лучи; при другом проходе они легли бы в другие места той же самой поверхности. Требуя, чтобы точка попала точно в соседа, мы требуем невозможного и штрафуем за скольжение вдоль стенки, которое ошибкой не является.
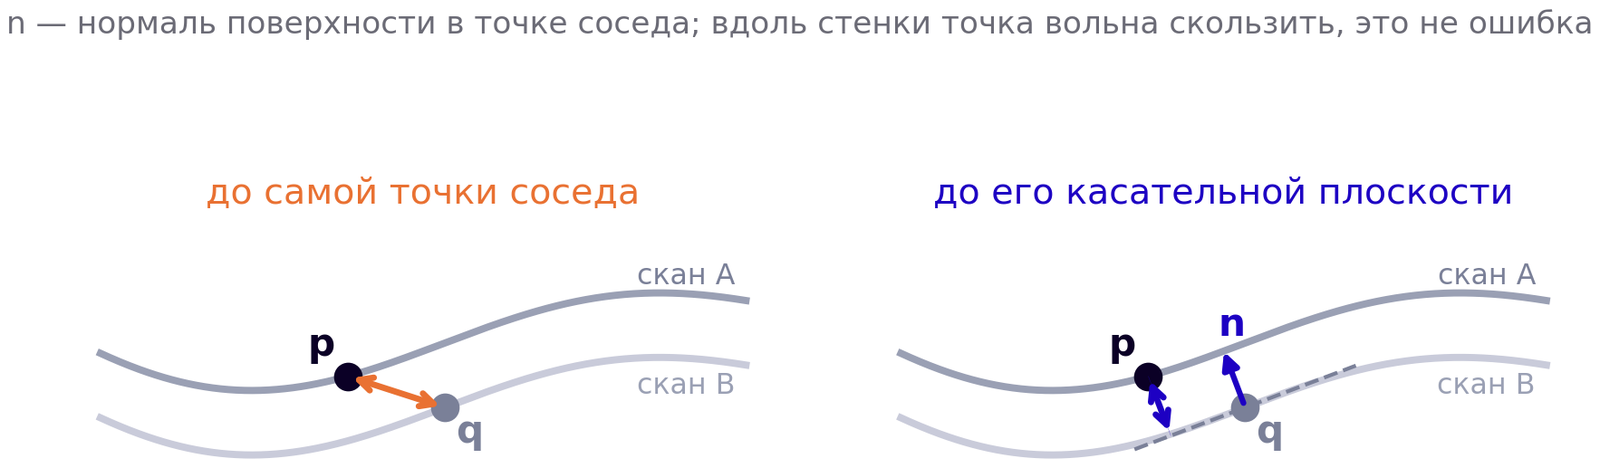
У точки соседа есть касательная плоскость, её направление задаётся нормалью $\mathbf{n}$. Нормаль считают по нескольким ближайшим точкам скана: берут их ковариацию и собственный вектор при наименьшем собственном числе. Это, кстати, ровно то почти-ядро из § 2.3.6: направление, вдоль которого облако почти не разбросано, и есть нормаль к плоскости, в которой оно лежит.
Невязка теперь — проекция разности на нормаль:
$$ r_i=\mathbf{n}_{j(i)}^\top\left(R\mathbf{p}_i+\mathbf{t}-\mathbf{q}_{j(i)}\right). $$
Одно число вместо трёх, в миллиметрах. Практический эффект известен и велик: с такой невязкой итерация сходится за единицы шагов там, где вариант «до точки» ползёт десятками, и особенно заметно это на плоских участках. Цена — нужны нормали, то есть предварительный проход по скану.
2.4.3. Потеря: что делать с неверными соседями
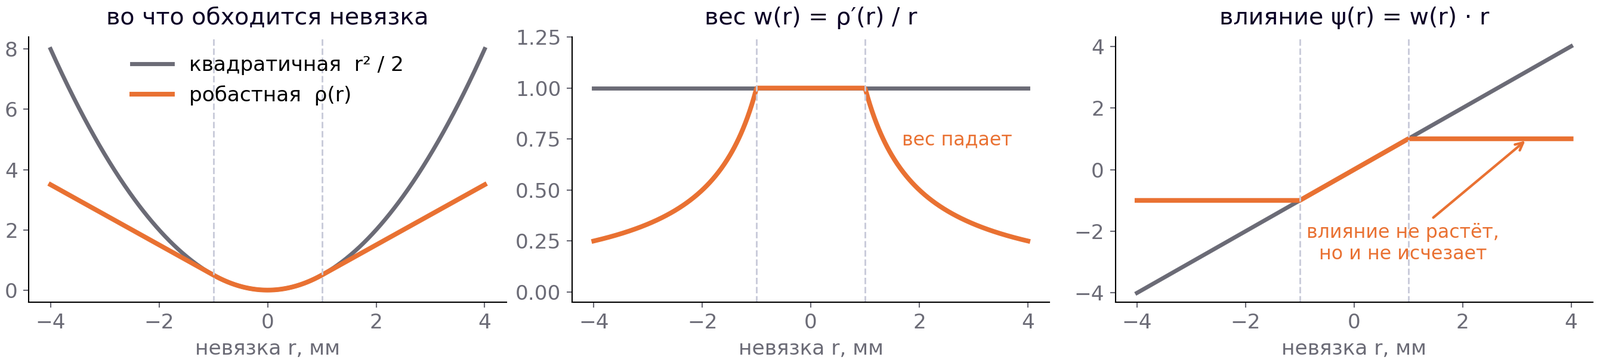
Слева серая парабола — квадратичная потеря: чем дальше промах, тем дороже, причём квадратично. Оранжевая — робастная: вблизи нуля совпадает с квадратичной, там всё честно, это обычный шум; дальше порога переходит на линейный рост.
В середине вес $w(r)=\rho'(r)/r$ — множитель, с которым невязка войдёт в систему на следующем шаге. У квадратичной потери он постоянный, у робастной после порога падает.
Справа — то, ради чего стоит третья панель, потому что здесь легко соврать. Вес и влияние — разные вещи. Влияние невязки на градиент равно $\psi(r)=\rho'(r)=w(r)\,r$. У Хьюбера за порогом $|\psi|$ не убывает, а выходит на константу: выброс перестаёт тянуть сильнее, но тянуть не перестаёт. Убывает именно вес, то есть влияние относительно квадратичной потери, которая росла бы линейно и дальше. Потери вроде Тьюки обнуляют $\psi$ совсем, и вот там выброс действительно выключается.
Порог ставят по ожидаемому шуму сканера, обычно около трёх стандартных отклонений. Это эвристика, а не граница между «измерением» и «не измерением»: даже в идеальной гауссовской модели за $\pm3\sigma$ выходит около 0,27 % честных измерений, а в ICP к шуму сенсора добавляется ещё и ошибка текущей позы. Конкретных робастных потерь много — Хьюбер, Коши, Тьюки, — и отличаются они тем, насколько резко гасят выброс: Хьюбер оставляет ему линейное влияние, Тьюки обнуляет совсем.
И оговорка, ради которой этот раздел стоит здесь, а не в конце. Именно неквадратичная потеря окончательно убивает замкнутую форму. Весь вывод Кабша держался на раскрытии квадрата: раскрыли, собрали след, взяли максимум. С любой другой потерей раскрывать нечего.
На практике это решают итеративно перевзвешенными наименьшими квадратами: на каждом шаге считают веса по текущим невязкам, а потом решают обычную взвешенную квадратичную задачу.
Оговорка, важная для реализации. Взвешенная квадратичная подзадача решается Кабшем только для невязки «точка минус точка»: там скалярные веса не портят структуру, и всё сводится к взвешенной кросс-ковариации. Для невязки до плоскости это не так. В сумме $\sum_i w_i\big[\mathbf{n}_i^\top(R\mathbf{p}_i+\mathbf{t}-\mathbf{q}_i)\big]^2$ каждое слагаемое смотрит только вдоль своей нормали, то есть под знаком суммы стоят проекторы $\mathbf{n}_i\mathbf{n}_i^\top$, и никакая фиксация соответствий их не убирает. Замкнутой формы здесь нет; решается она линеаризацией, и этим мы займёмся в § 2.6.
2.4.4. Функционал целиком
Собираем три изменения в одну строку, где теперь каждый символ определён. Было:
$$ E(R,\mathbf{t})=\sum_i\big\|R\mathbf{p}_i+\mathbf{t}-\mathbf{q}_i\big\|^2, \qquad\text{пары }(\mathbf{p}_i,\mathbf{q}_i)\text{ заданы.} $$
Стало:
$$ E(R,\mathbf{t})=\sum_i\rho\Big(\mathbf{n}_{j(i)}^\top\big(R\mathbf{p}_i+\mathbf{t}-\mathbf{q}_{j(i)}\big)\Big), \qquad j(i)=\arg\min_j\big\|R\mathbf{p}_i+\mathbf{t}-\mathbf{q}_j\big\| . $$
Здесь $\rho$ — робастная потеря из § 2.4.3, $\mathbf{n}$ — нормаль в точке соседа из § 2.4.2, а $j(i)$ — сам сосед.
Вторая строка и ломает всё остальное. Индекс соседа не константа, а функция от $R$ и $\mathbf{t}$, которые мы как раз и ищем. Раскрыть скобки и собрать кросс-ковариацию, как в § 2.3.4, нельзя: при изменении $R$ меняется не только то, что внутри скобок, но и то, какие точки в них стоят. Функционал кусочно-гладкий, и у него есть локальные минимумы.
Отсюда схема, которая называется ICP (iterative closest point, Besl & McKay, 1992; вариант с расстоянием до плоскости — Chen & Medioni, 1992). Два шага по кругу: при текущих $R$ и $\mathbf{t}$ найти для каждой точки ближайшего соседа и зафиксировать его; при зафиксированных соседях улучшить $R$ и $\mathbf{t}$. Повторять, пока решение не перестанет меняться.
Кабш при этом не выброшен, но роль у него теперь одна: дать начальное приближение по нескольким размеченным парам. Решать второй шаг он не может — почему, сказано в § 2.4.3.
Остаётся единственный нерешённый вопрос: что значит «улучшить $R$». Улучшить — значит сдвинуть на маленькую поправку, и вот тут выясняется, что прибавить поправку к матрице поворота негде.
2.5. Чем записывать вращение
2.5.1. Что будет, если всё-таки прибавить поправку
Проверим прямо. Возьмём функционал наименьших квадратов по фиксированным парам — самый простой, чтобы поломка была видна в чистом виде, — посчитаем производную по всем девяти числам матрицы и сделаем обычный градиентный шаг $R\leftarrow R-\eta\,\partial E/\partial R$. Шаг маленький, устойчивый, никакой расходимости.
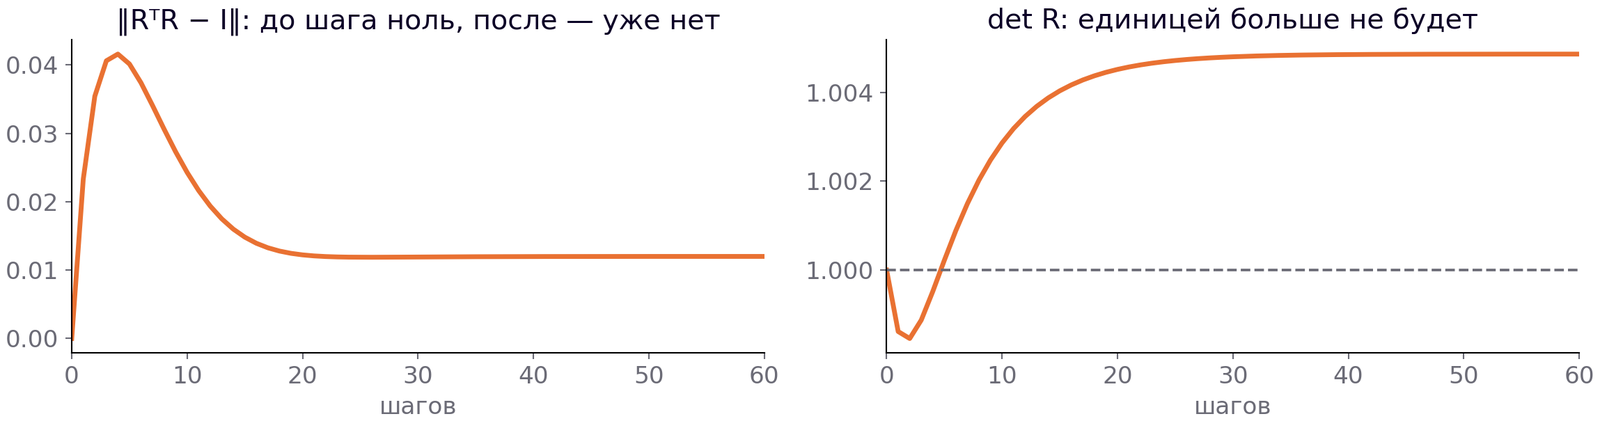
За 400 шагов норма $\|R^\top R-I\|$ доходит до $0{,}012$, а определитель до $1{,}005$. Матрица перестала быть поворотом: она теперь чуть-чуть растягивает и чуть-чуть скашивает деталь — ровно та поломка, которую мы видели в § 2.3.2, только теперь она приезжает не из наивной постановки, а из самого шага оптимизации.
И никто не жалуется: невязка честно падает, ошибок нет, предупреждений нет. Минимум по всем матрицам не больше минимума по поворотам, поэтому оптимизатор с удовольствием уходит с множества вращений — там просто лучше.
Причина арифметическая, и её стоит назвать вслух. Вращения не образуют линейного пространства. Девять чисел матрицы лежат не во всём девятимерном пространстве, а на кривой трёхмерной поверхности внутри него. А вся численная оптимизация состоит ровно из двух операций: сложить и умножить на число. Обе с этой поверхности уводят.
Проверьте на простом: сложите два поворота на девяносто градусов вокруг разных осей и поделите пополам. Получится матрица, которая ни на что не похожа. Среднее двух поворотов поворотом не является.
2.5.2. Чинить снаружи или считать внутри
Напрашивается обход, и он законный. Проецировать на множество поворотов мы умеем: максимизация следа $\operatorname{tr}(R^\top A)$ из § 2.3.7 и есть поиск ближайшей к $A$ матрицы, а ответ там получился $UV^\top$ — с той же поправкой на определитель, потому что без неё это ближайшая ортогональная матрица, а не ближайший поворот. Значит, шагаем как попало, а после каждого шага возвращаем матрицу обратно.
Чтобы разобраться, сведём картинку к плоской. Вместо множества поворотов возьмём окружность: тоже кривая, тоже задана ограничением, только одномерная и её видно.
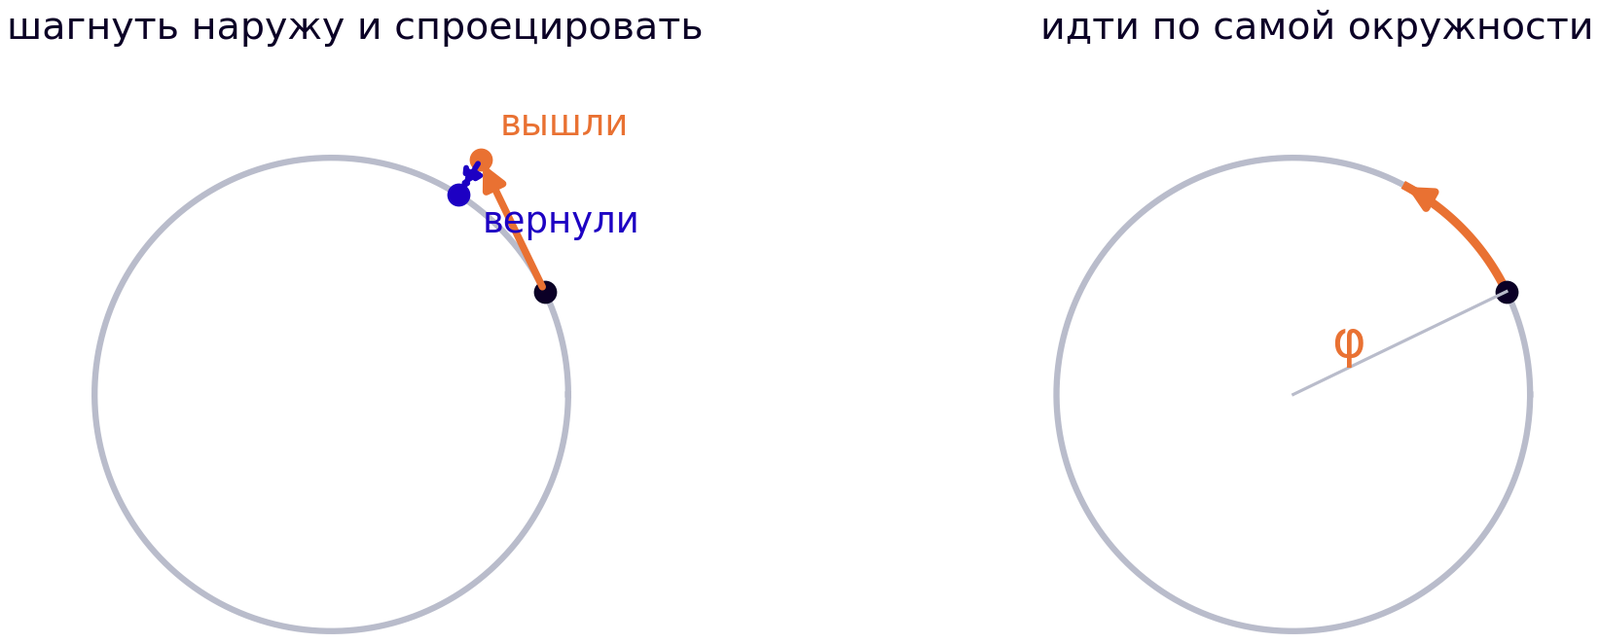
Слева обход. Стоим на окружности, делаем шаг по касательной, вышли наружу, возвращаем проекцией. Работает, и работает честно: проекция $\mathbf{x}\mapsto\mathbf{x}/\|\mathbf{x}\|$ гладкая всюду, кроме нуля, её производная равна $(I-\mathbf{u}\mathbf{u}^\top)/\|\mathbf{x}\|$, и проекция матрицы на повороты тоже дифференцируема в окрестности $SO(3)$. Так что оптимизировать с проекцией можно, и так делают.
Неудобства у этого пути другие, и их три. Шаг задали один, а пройденный по окружности угол вышел другой, и чем крупнее шаг, тем сильнее расхождение. Неизвестных остаётся девять, хотя степеней свободы три, поэтому система вырождена и её приходится регуляризовать. И производные приходится проводить через разложение, что дороже и хрупче около вырожденных матриц.
Справа другая ветка: не выходить вовсе, а двигаться по самой окружности. Тогда нужна её собственная координата — угол $\varphi$. Одно число, никаких ограничений: любое $\varphi$ задаёт точку на окружности, и любая точка получается из какого-то $\varphi$.
Вот требование, с которым идём дальше. Ограничение надо унести внутрь параметризации, чтобы снаружи остались свободные числа. У окружности таких чисел одно: два числа минус одно уравнение. У множества поворотов их три: девять минус шесть, как посчитано в § 2.2.6.
Осталось найти эти три числа.
2.5.3. Любой поворот — это три угла
Три числа нужны, три и берём. Самый очевидный способ: повернуть вокруг одной оси координат, потом вокруг второй, потом вокруг третьей.
$$ R(\alpha,\beta,\gamma)=R_z(\alpha)\,R_y(\beta)\,R_x(\gamma). $$
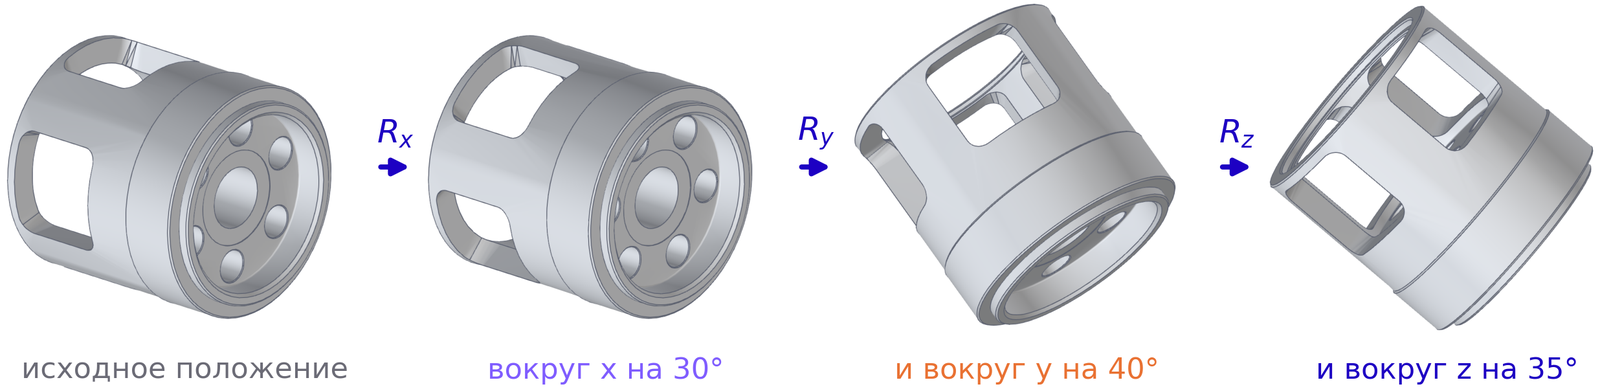
На порядок стоит посмотреть внимательно, потому что здесь легко ошибиться. Матрица $R=R_z R_y R_x$ действует на точку справа налево, так что первым поворотом является $R_x$. Каждый следующий множитель приписывается слева и поворачивает уже повёрнутое тело вокруг оси комнаты, а не вокруг собственной оси детали. Если накапливать множители справа, получится другая последовательность — повороты вокруг подвижных осей самой детали, и это другая конвенция с другим результатом.
Верно ли, что так можно получить любой поворот? Да, и это несложно понять: один угол приводит нужную ось в нужную плоскость, второй доводит её до нужного направления, третий доворачивает вокруг неё саму деталь.
Проверим по требованию из § 2.5.2. Ограничение исчезло внутрь параметризации: любая тройка углов задаёт законный поворот, никаких уравнений между углами нет. Формально всё, что мы просили, выполнено.
Первая цена бытовая, но дорогая. Осей три, порядок можно выбрать двадцатью четырьмя способами: какие оси, в каком порядке, вокруг неподвижных или вокруг уже повёрнутых. Все двадцать четыре встречаются в живом коде, и углы из паспорта датчика с углами из библиотеки, как правило, разных конвенций.
2.5.4. Замок: три ручки, две степени свободы
Вторая цена принципиальная.
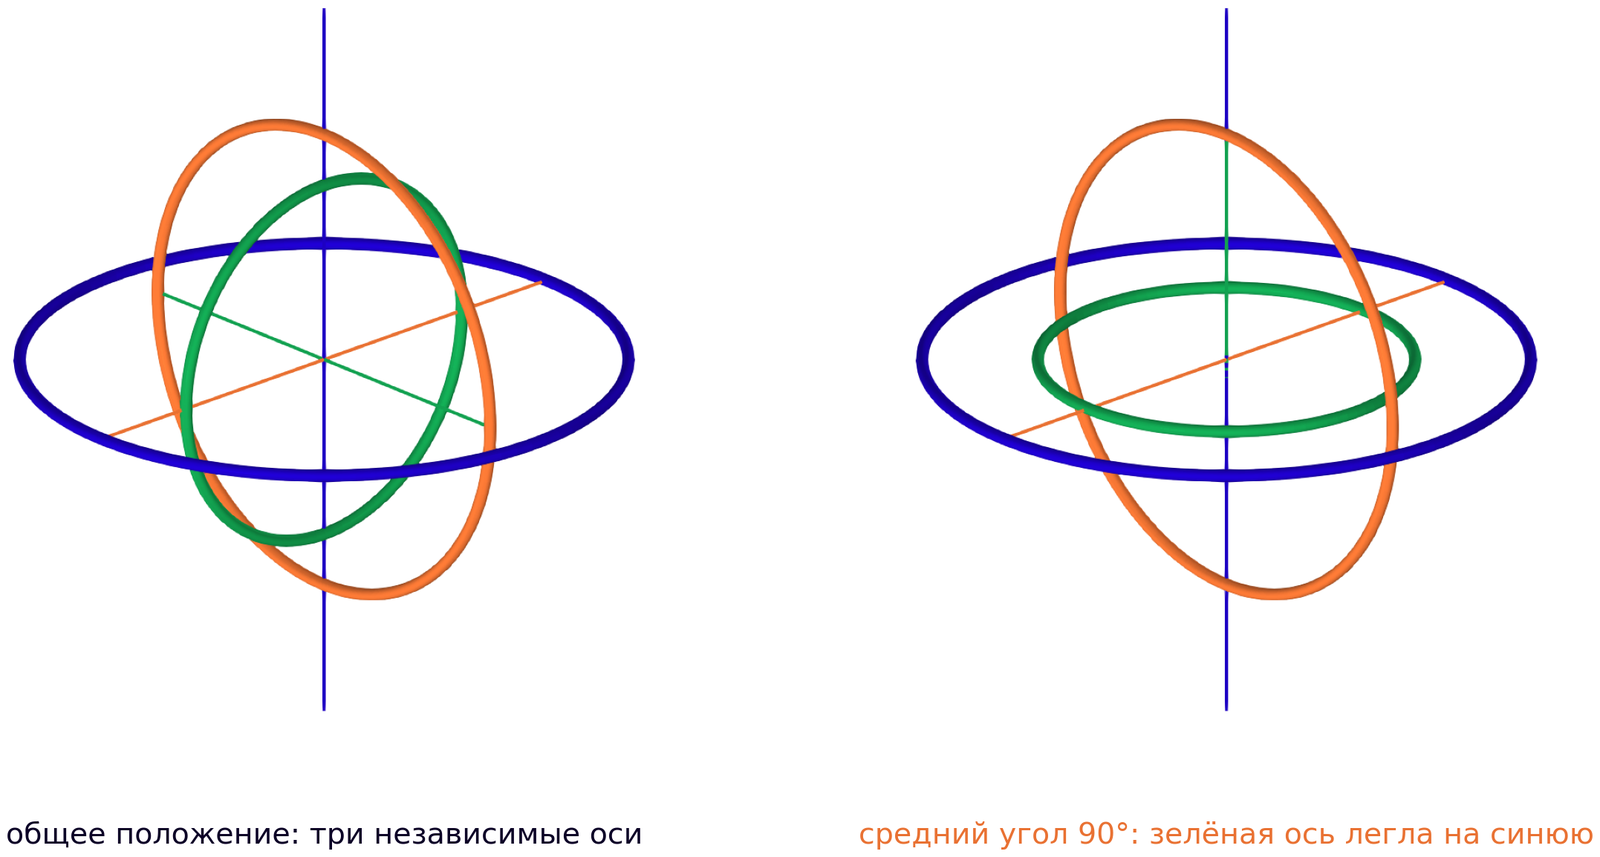
Справа два кольца крутят деталь вокруг одного и того же направления. Ручек по-прежнему три, а независимых движений стало два: целое направление вращения из тройки углов недостижимо.
Записать это можно точно. При $\beta=\pi/2$ матрица $R(\alpha,\beta,\gamma)$ зависит только от разности $\alpha-\gamma$: подставьте и убедитесь, что два угла входят одной комбинацией. Явление называется gimbal lock, замок подвеса, и название пришло из гироскопов, где кольца физические. С нами это происходит в чистой арифметике, безо всяких колец.
Что это значит для оптимизации, а не для авиации. Само отображение «углы в матрицу» около замка ведёт себя смирно: элементы $R_zR_yR_x$ и их производные по углам ограничены, ничего не разлетается. Плохо становится обратной задаче. Некоторые изменения углов почти компенсируют друг друга, и чтобы получить заданный маленький доворот детали, углам приходится меняться на много. В оптимизации это и вылезает: система на поправку углов плохо обусловлена, решение раздувается, а шаг перестаёт соответствовать намерению.
Естественная реакция: переставим оси. Она правильная и бесполезная.
2.5.5. Дырку нельзя убрать, можно только переставить
Переставим оси — замок уйдёт. В другое место. Причина не в конвенции, а в форме самого множества поворотов.
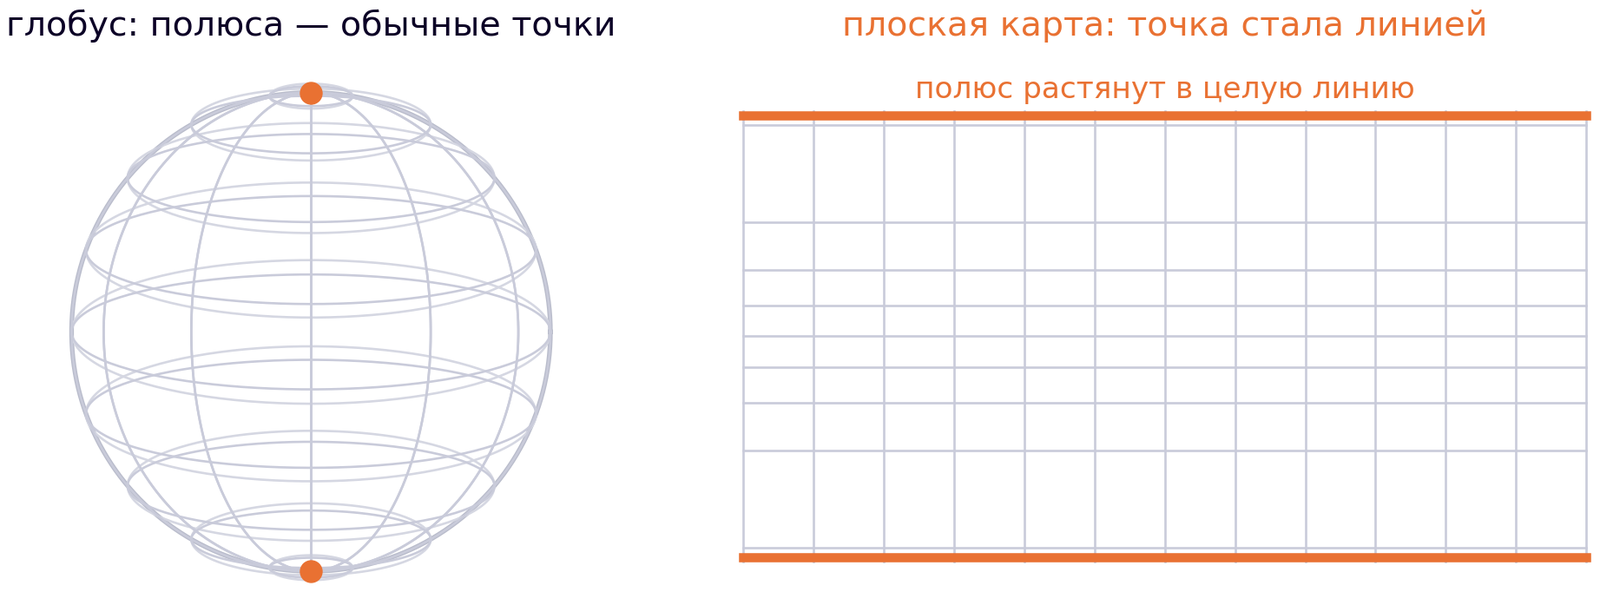
Аналогия точная, а не образная. Глобус — замкнутая искривлённая поверхность, задать её двумя числами без разрыва или слипания нельзя: на полюсе долгота теряет смысл, все меридианы сходятся. Убрать это невозможно, можно повернуть глобус и получить разрыв в другом месте. С поворотами то же самое, только поверхность трёхмерная, а лист из трёх чисел.
Теперь количественно, потому что это важнее самого факта. Угловая скорость выражается через скорости трёх углов линейно, $\boldsymbol\omega=E(\beta,\gamma)\,(\dot\alpha,\dot\beta,\dot\gamma)^\top$, и определитель этой матрицы равен $\cos\beta$.
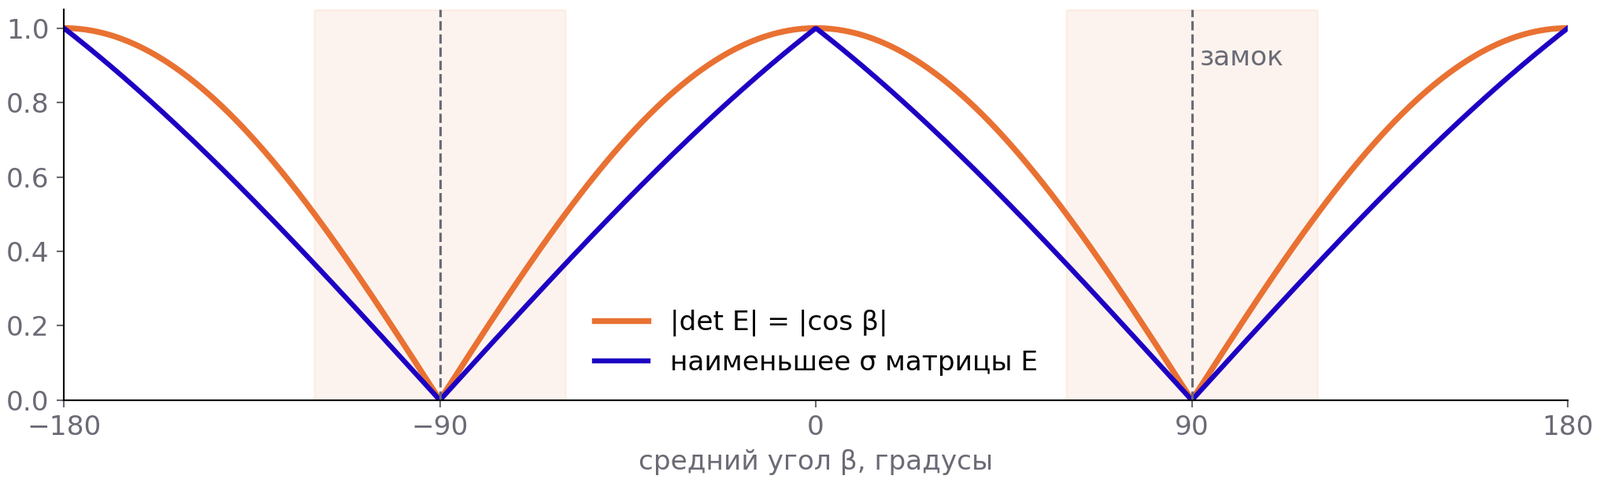
Смотрите, где начинается беда. Уже при $\beta=60°$ наименьшее сингулярное число равно $0{,}37$: чтобы повернуть деталь на градус в неудачном направлении, углам надо измениться почти на три. Затенённые полосы на рисунке — рабочая зона плохих чисел, а не экзотика для авиасимуляторов.
Вывод, с которым идём дальше. Дырка неизбежна, спорить не о чем. Значит, надо выбрать параметризацию, у которой она стоит там, где мы никогда не работаем. А работаем мы около нулевого поворота, потому что считаем маленькие поправки. Значит, дырку надо отправить на разворот, на сто восемьдесят градусов.
Для этого три числа надо привязать не к осям комнаты, а к самому повороту.
2.5.6. Ось и угол
Теорема Эйлера о вращении: любой поворот трёхмерного пространства есть поворот вокруг некоторой оси на некоторый угол. Не композиция трёх, а один поворот вокруг одной оси.
Доказательство в одну строку. У матрицы $3\times3$ есть вещественное собственное значение; из $R^\top R=I$ следует, что все собственные значения по модулю равны единице, а из $\det R=+1$ — что вещественное равно $+1$. Собственный вектор при нём и есть ось: она остаётся на месте.
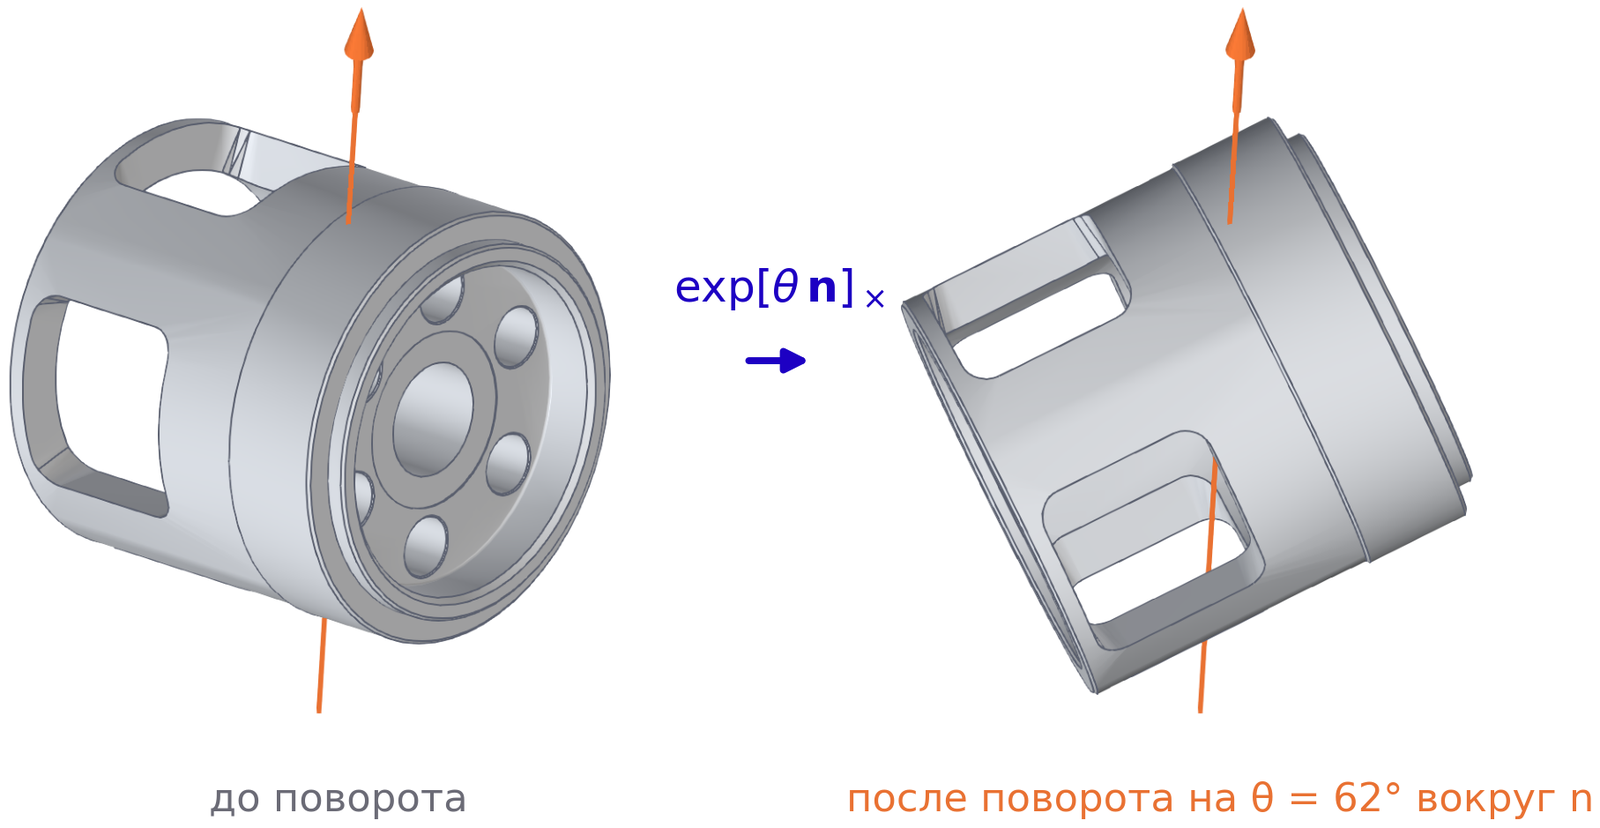
Значит, три числа напрашиваются сами: единичный вектор оси $\mathbf{n}$ и угол $\theta$. Их сворачивают в один вектор поворота
$$ \boldsymbol\omega=\theta\,\mathbf{n},\qquad \|\mathbf{n}\|=1,\qquad \theta\in[0,\pi]. $$
Что мы выиграли по сравнению с углами Эйлера. Порядка множителей и выбора подвижных осей здесь нет, так что целого класса конвенций мы избежали. Остаются, разумеется, другие: в каком базисе записан $\mathbf{n}$, в какую сторону действует преобразование, с какой стороны применяется приращение.
Про ограничения надо сказать точно, потому что тут два разных объекта. Вектор приращения $\boldsymbol\omega\in\mathbb{R}^3$ ограничений не имеет: экспонента определена для любых трёх чисел, и именно этим мы будем пользоваться в § 2.6. Каноническая запись готового поворота — другое дело: чтобы она была однозначной, угол берут из $[0,\pi]$, то есть вектор живёт в шаре радиуса $\pi$, у которого противоположные точки границы отождествлены. Векторы $\boldsymbol\omega$ и $\boldsymbol\omega+2\pi\mathbf{n}$ задают один и тот же поворот.
Особенность не исчезла, она переехала: при $\theta=\pi$ ось определена с точностью до знака. От нуля это максимально далеко, а работаем мы как раз около нуля. Топологическое препятствие из § 2.5.5 никуда не делось, и никакая тройка чисел от него не свободна.
Для нашей задачи это ещё и удобная мера: расхождение двух сканов теперь одно число, угол, по которому можно поставить допуск.
Но пока это только имя поворота. Чтобы повернуть облако точек, из $\boldsymbol\omega$ нужна матрица.
2.5.7. Уравнение вращения даёт экспоненту
Получим её не угадыванием, а из того, что такое вращение.
Пусть тело вращается с постоянной угловой скоростью $\boldsymbol\omega$. Скорость точки при этом равна векторному произведению: формула школьная, и её можно проверить на пальцах, потому что скорость перпендикулярна и оси, и радиусу, а по величине равна $\|\boldsymbol\omega\|$ на расстояние до оси.
Векторное произведение на фиксированный вектор — линейная операция, и её матрица кососимметрична; обозначим её $[\boldsymbol\omega]_\times$. Тогда движение точки описывается уравнением
$$ \dot{\mathbf{x}}=\boldsymbol\omega\times\mathbf{x}=[\boldsymbol\omega]_\times\mathbf{x} \qquad\Longrightarrow\qquad \mathbf{x}(t)=\exp\!\big(t\,[\boldsymbol\omega]_\times\big)\,\mathbf{x}(0). $$
Это обыкновенное линейное дифференциальное уравнение с постоянной матрицей, и решение у него известно и единственно — тот же факт, что и для скалярного $\dot x=ax$, только вместо числа матрица.
Возьмём $t=1$. Слева стоит точка, повёрнутая на угол $\|\boldsymbol\omega\|$ вокруг направления $\boldsymbol\omega$: за единицу времени тело как раз столько и повернулось. Справа — экспонента от $[\boldsymbol\omega]_\times$. Вот и всё: матрица поворота равна экспоненте кососимметричной матрицы, и ниоткуда, кроме уравнения вращения, она не берётся.
2.5.8. Ряд сворачивается: формула Родригеса
Экспонента матрицы определяется тем же рядом, что и обычная:
$$ \exp K=I+K+\frac{K^2}{2!}+\frac{K^3}{3!}+\dots $$
Считать бесконечный ряд не придётся. Для кососимметричной матрицы единичной оси выполняется $[\mathbf{n}]_\times^3=-[\mathbf{n}]_\times$ — проверьте прямым умножением, это тождество для векторного произведения. Значит, все степени сводятся к двум: четвёртая есть минус квадрат, пятая снова сама матрица, и так по кругу. Ряд распадается на два: при матрице собирается ряд синуса, при её квадрате — ряд $1-\cos$. Получается формула Родригеса (о её численных ловушках — Grassia, 1998):
$$ R=I+\sin\theta\,[\mathbf{n}]_\times+(1-\cos\theta)\,[\mathbf{n}]_\times^2 . $$
Десяток арифметических операций, не дороже наивного обрыва, а результат — точный поворот.
Обратная операция называется логарифмом и достаёт $\boldsymbol\omega$ из матрицы: угол берут из следа, $\cos\theta=(\operatorname{tr}R-1)/2$, ось — из кососимметричной части $R-R^\top$.
Экспонента гладкая везде, трудность только в выборе однозначной обратной ветви, и в реализации она даёт два особых случая. При $\theta\to0$ кососимметричная часть стремится к нулю вместе с углом, и наивное деление теряет точность — нужны предельные формулы. При $\theta=\pi$ выходит $R=R^\top$, кососимметричная часть равна нулю тождественно, и ось приходится доставать из симметричной части $R+I$. Библиотечные реализации оба случая обрабатывают отдельно, и свою стоит писать так же.
$$ R=\exp[\boldsymbol\omega]_\times,\qquad \boldsymbol\omega=\log R . $$
И название, которое понадобится в § 2.6. Кососимметричные матрицы $3\times3$ образуют обычное линейное пространство: их можно складывать и умножать на число, кососимметричность от этого не портится. Это и есть касательное пространство к множеству поворотов, обозначается $\mathfrak{so}(3)$. Экспонента переносит оттуда на множество поворотов, логарифм возвращает обратно. Именно в этом пространстве мы и будем считать поправки.
2.5.9. Почему нельзя просто оборвать ряд
Возникает соблазн. Мы работаем с маленькими поправками, а при малом угле $\sin\theta\approx\theta$ и $1-\cos\theta\approx0$. Значит, можно оставить первый член: $R\approx I+[\boldsymbol\omega]_\times$. Дешевле и как будто достаточно.
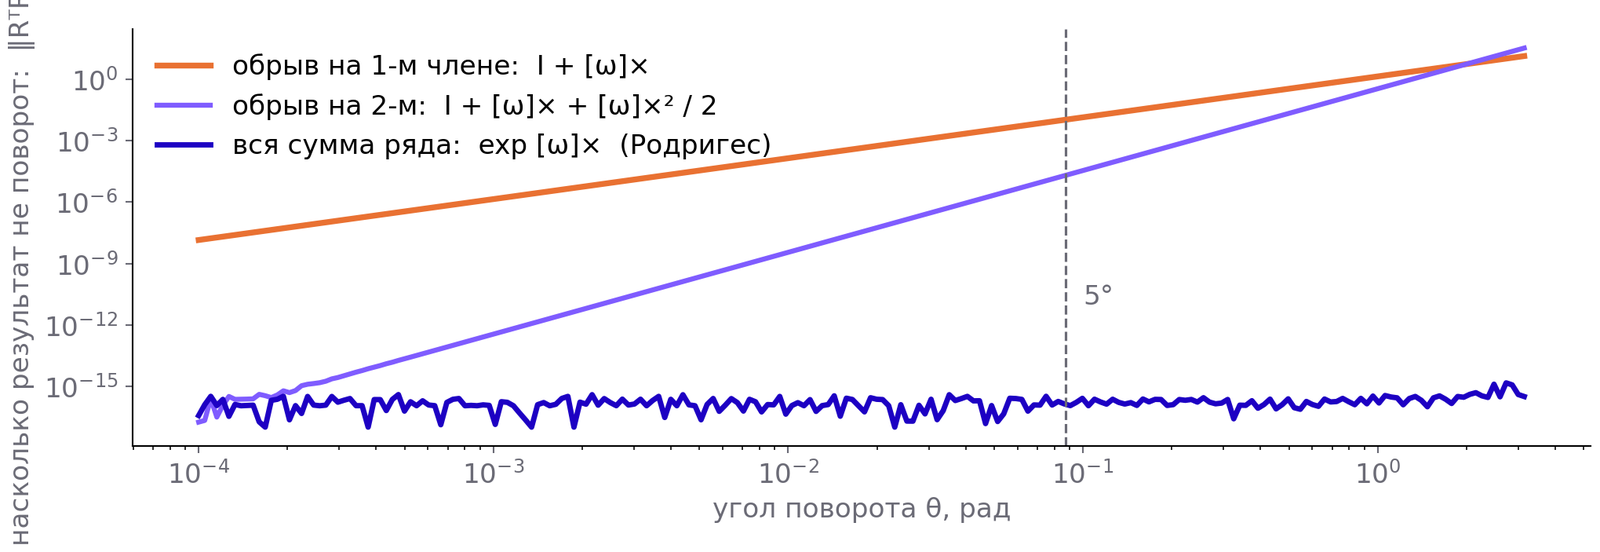
Обрыв на первом члене растёт как квадрат угла: уже при $5°$ отклонение $\|R^\top R-I\|$ составляет около $1{,}1\cdot10^{-2}$. Для сравнения, пять градусов — это типичный шаг итерации, а не экзотика. Второй член улучшает дело на порядки, но природа та же: это по-прежнему обрыв и по-прежнему не поворот. Полная сумма лежит на уровне машинной точности при любом угле вплоть до разворота.
Главное здесь не точность. Беда в том, что результат перестаёт принадлежать множеству поворотов — ровно то, с чего начался весь раздел. Мы потратили пять подразделов, чтобы уйти с этих граблей, и обрыв ряда возвращает нас на них. Причём накапливается это по итерациям: сто шагов по пять градусов, и деталь заметно скошена, а предупреждения не было.
2.5.10. Кватернион: та же ось, тот же угол
Двигать вращение мы умеем. Но двигать — не единственный глагол: есть ещё сцеплять и хранить, и там у обеих наших записей проблемы.
Векторы поворота не складываются и не сцепляются: $\exp[\mathbf{a}]_\times\exp[\mathbf{b}]_\times\neq\exp[\mathbf{a}+\mathbf{b}]_\times$, потому что повороты не коммутируют. Матрицы сцепляются прекрасно, но в длинной цепочке произведений накапливается погрешность округления. Я это измерил: двести тысяч композиций в одинарной точности уводят матрицу от ортогональности на $8{,}7\cdot10^{-3}$, а кватернион от единичной длины — на $8{,}9\cdot10^{-4}$.
Кватернион — четвёрка чисел, одно скалярное и три векторных, $q=(w,\mathbf{v})$. Связь с тем, что мы уже знаем, прямая: по теореме Эйлера у поворота есть ось $\mathbf{n}$ и угол $\theta$; возьмите ровно их и положите в четвёрку
$$ q=\big(\cos(\theta/2),\;\sin(\theta/2)\,\mathbf{n}\big). $$
Кватернион поворота — это та же ось и тот же угол, просто упакованные иначе.
Почему половина угла. Потому что кватернион входит в правило применения дважды: точку записывают как кватернион с нулевой скалярной частью и берут $q\,(0,\mathbf{x})\,q^*$, где $q^*=(w,-\mathbf{v})$ — сопряжённое.
Говорить, что каждое умножение поворачивает точку на половину угла, было бы неточно: отдельное произведение $q\,(0,\mathbf{x})$ вообще не обязано быть чисто векторным, у него появляется скалярная часть, и трёхмерного поворота там ещё нет. Оба умножения работают в четырёхмерном пространстве кватернионов, скалярные части взаимно уничтожаются, и только результат целиком оказывается вектором. Проверить проще всего на оси $z$: возьмите $q=(\cos(\theta/2),\,0,0,\sin(\theta/2))$, раскройте $q(0,\mathbf{x})q^*$ по правилу умножения и убедитесь, что получился поворот на $\theta$, а половины угла сложились.
Длина такой четвёрки равна единице: $\cos^2+\sin^2$. Это единственное ограничение, и геометрический смысл у него простой — единичные кватернионы лежат на сфере в четырёхмерном пространстве. Четыре числа, одно уравнение, три степени свободы, как и должно быть.
Правило умножения:
$$ q_1q_2=\big(w_1w_2-\mathbf{v}_1\!\cdot\!\mathbf{v}_2,\;\;w_1\mathbf{v}_2+w_2\mathbf{v}_1+\mathbf{v}_1\!\times\!\mathbf{v}_2\big). $$
Именно из-за векторного произведения умножение некоммутативно, и это правильно, потому что повороты тоже не коммутируют. Стоимость: шестнадцать умножений против двадцати семи у матриц, и четыре числа памяти против девяти.
Но главное не стоимость сцепления, а цена починки. У матрицы шесть уравнений связи, и вернуть её на множество поворотов стоит разложения — того самого $UV^\top$. У кватерниона уравнение одно и скалярное: поделить четвёрку на её длину. Это делают на каждом шаге и не думают.
Двойное накрытие. Кватернионы $q$ и $-q$ задают один и тот же поворот: подставьте в правило применения, минусы сократятся. Видно это и из половины угла: прибавьте к $\theta$ полный оборот, поворот тот же, а половина угла сдвинулась на $\pi$, и вся четвёрка сменила знак. На практике означает, что перед сравнением и усреднением знаки надо согласовать, иначе два одинаковых поворота окажутся максимально далёкими.
2.5.11. Что такое slerp
Задача: даны две ориентации, надо построить плавный переход между ними. Нужна анимации, сглаживанию траектории сканера, любой интерполяции поз.
Схема эта называется slerp и введена Шумейком в 1985 году. Ключ к пониманию уже есть: единичные кватернионы лежат на сфере. Значит, интерполировать две ориентации — это соединить две точки на сфере.
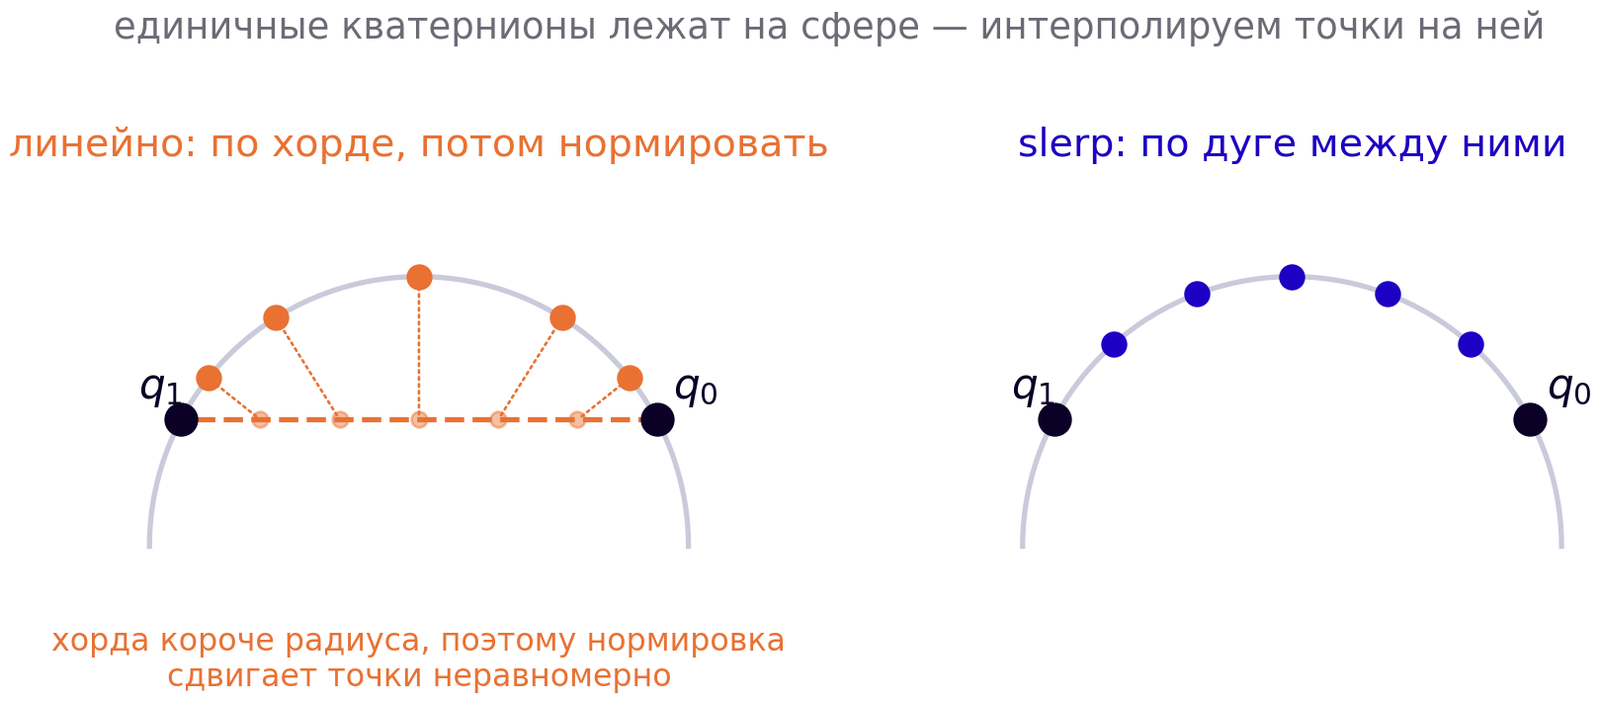
Наивный способ: усреднить четвёрки покомпонентно, как обычные векторы. Это движение по хорде, по прямой внутри сферы. Хорда лежит внутри, длина промежуточной четвёрки меньше единицы, поэтому результат приходится нормировать, то есть выталкивать обратно на сферу. И вот здесь беда: хорда короче в середине сильнее, чем у концов, нормировка выталкивает середину сильнее, и равномерные шаги по хорде превращаются в неравномерные шаги по сфере.
Правильный способ — идти по самой дуге большого круга равными угловыми шагами:
$$ \mathrm{slerp}(q_0,q_1;t)=\frac{\sin\big((1-t)\Omega\big)}{\sin\Omega}\,q_0+\frac{\sin(t\Omega)}{\sin\Omega}\,q_1, \qquad \cos\Omega=q_0\!\cdot\!q_1 . $$
Название расшифровывается как spherical linear interpolation: линейная, потому что угол растёт линейно по параметру, сферическая, потому что движение идёт по сфере, а не по хорде.
Заметьте, что это ровно та же развилка, что и в § 2.5.2: шагнуть наружу и вернуть проекцией или идти по самой поверхности. Здесь она же, только на сфере кватернионов.
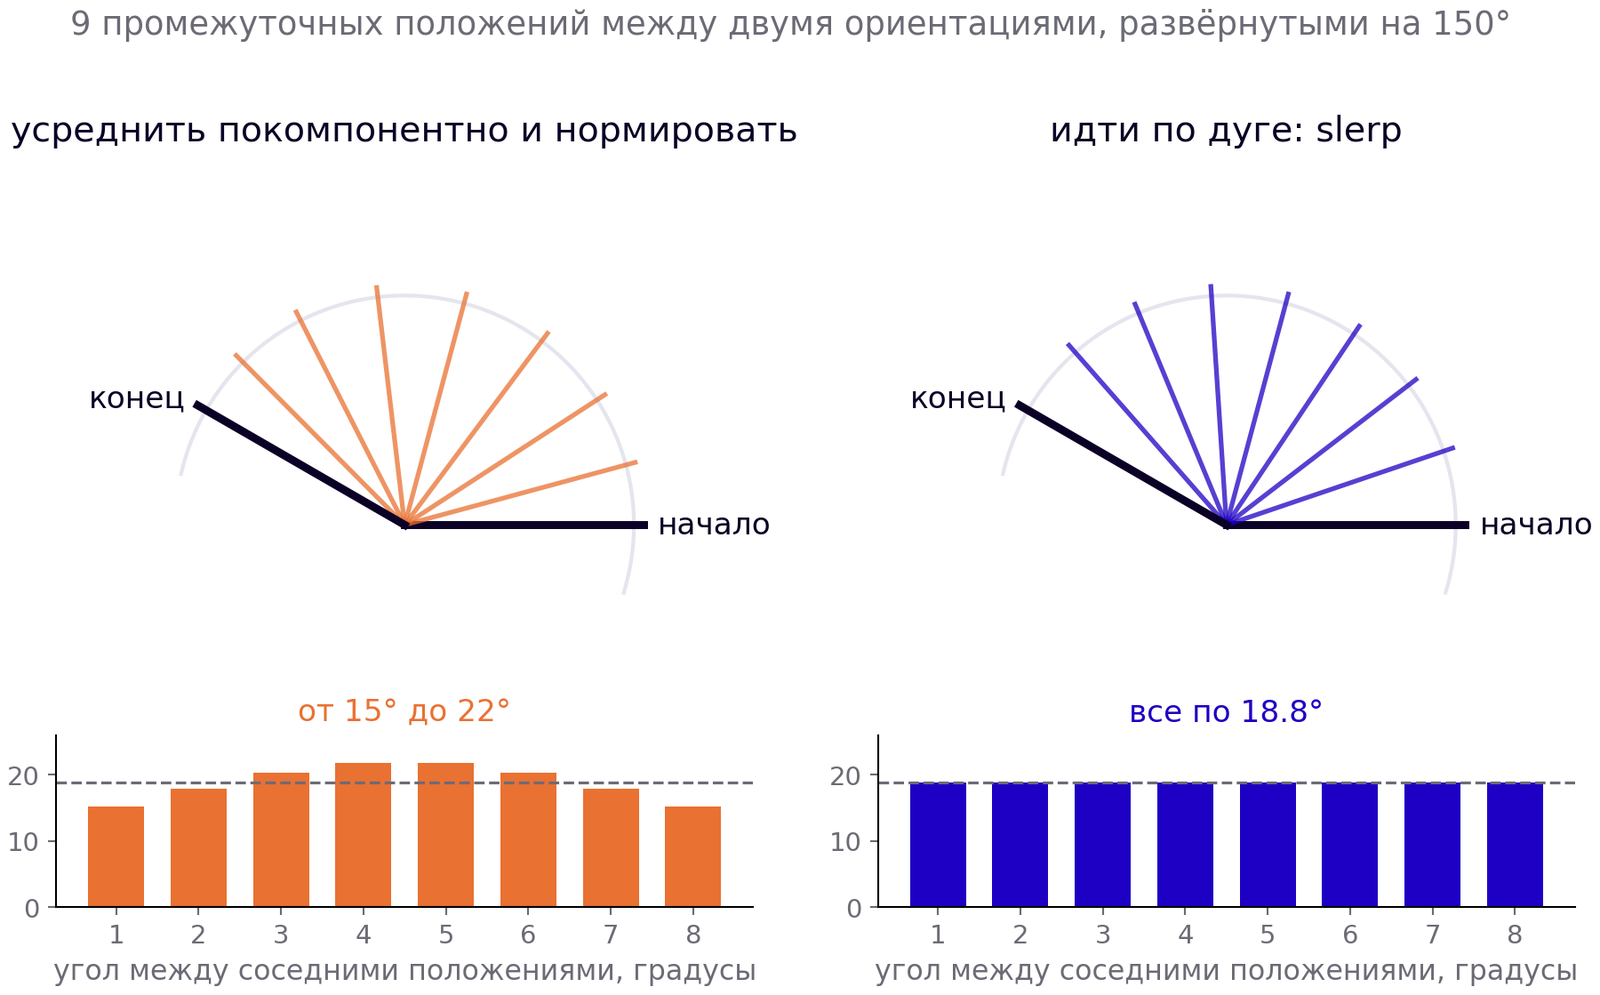
Проверим на числах. При покомпонентном усреднении шаги гуляют от $15{,}2°$ до $21{,}7°$, при движении по дуге все равны $18{,}75°$. Разброс почти в полтора раза, и физически это неравномерная угловая скорость: деталь на видео то замедляется, то ускоряется. На больших углах разница видна глазом, на малых её нет.
И ловушка, которая ждёт всех: при несогласованных знаках интерполяция честно пойдёт по дуге, но по длинной, через больший угол. Лечится одной строкой: если скалярное произведение отрицательно, поменяйте знак одной из четвёрок.
2.5.12. Одно вращение, четыре глагола
Представлений четыре, и ни одно не годится для всего. Это не недоработка: каждое появилось как ответ на конкретный отказ предыдущего. Правило выбора про глагол, а не про объект.
| Что делаете | Чем | Почему |
|---|---|---|
| применить к точкам | матрица $3\times3$ | умножение на вектор, быстрее нечего |
| хранить и интерполировать | кватернион | ограничение чинится делением, slerp даёт равные шаги |
| оптимизировать | приращение $\boldsymbol\omega$ через $\exp$ | три свободных числа, результат — точный поворот |
| показать человеку | углы Эйлера | только показать; считать в них не надо |
И оговорка: держите направление и конвенцию в имени переменной. Для матриц мы это уже говорили в § 2.2.7, для остальных записей верно ровно так же.
Осталась одна строка правила, которую мы объявили, но не заслужили: оптимизировать приращением. Мы знаем, чем шагать. Как из этого собирается настоящая итерация — следующий раздел.
2.6. Как уточнить решение
2.6.1. Что именно мы ищем на каждом шаге
Что у нас есть: текущее преобразование, матрица $R$ и вектор $\mathbf{t}$. Оно уже примерно верное, его дал Кабш по нескольким размеченным парам.
Что мы хотим: немного его подправить. Из § 2.5 мы знаем, что прибавлять к $R$ нельзя, а надо умножать на маленький поворот, и что маленький поворот записывается тремя числами и применяется экспонентой. Отсюда правило шага:
$$ R\leftarrow\exp[\boldsymbol{\delta\varphi}]_\times R, \qquad \mathbf{t}\leftarrow\exp[\boldsymbol{\delta\varphi}]_\times\mathbf{t}+\boldsymbol{\delta\rho}. $$
Здесь $\boldsymbol{\delta\varphi}$ — три числа, задающие маленький поворот, $\boldsymbol{\delta\rho}$ — три числа, задающие маленький сдвиг. Экспонента от кососимметричной матрицы ортогональна с определителем $+1$, поэтому $R$ после умножения остаётся поворотом точно, а не приближённо.
Складываем шесть чисел в один столбец:
$$ \boldsymbol\delta=(\boldsymbol{\delta\varphi},\,\boldsymbol{\delta\rho})\in\mathbb{R}^6 . $$
Это и есть неизвестное итерации. Подчеркнём: у него нет ограничений. Любые шесть чисел законны, потому что ограничение спрятано в экспоненте — ровно то, чего мы добивались в § 2.5.2.
И заметьте, чего мы не ищем. Мы не ищем $R$ и $\mathbf{t}$ заново, мы ищем поправку к тому, что уже есть. После применения поправка вкатывается в $R$ и $\mathbf{t}$, а $\boldsymbol\delta$ обнуляется, и на следующем шаге мы снова стоим в нуле. Поэтому особенность при $\theta=\pi$ из § 2.5.6 до нас никогда не дотягивается: мы всегда работаем около нуля.
Замечание о конвенции. Здесь приращение умножается слева, а порядок в шестёрке — сначала поворот. На семинаре и в домашнем задании принята другая конвенция: $T\leftarrow T\exp(\boldsymbol\xi^\wedge)$ с порядком $\boldsymbol\xi=(\boldsymbol\rho,\boldsymbol\omega)$ и переносом через матрицу $V(\boldsymbol\omega)$. Обе записи корректны, но якобианы у них разные, поэтому при сверке кода с этой главой держите конвенцию в голове.
2.6.2. Как невязка зависит от поправки
Свяжем $\boldsymbol\delta$ с данными. Вводим ещё две величины.
$\mathbf{x}_i=R\mathbf{p}_i+\mathbf{t}$ — точка первого скана в её текущем положении: исходная точка, к которой уже применены нынешние $R$ и $\mathbf{t}$. Не исходная и не идеальная, а та, где она стоит прямо сейчас.
$r_i=\mathbf{n}_i^\top(\mathbf{x}_i-\mathbf{q}_i)$ — текущая невязка этой точки, то самое расстояние до касательной плоскости из § 2.4.2. Одно число, в миллиметрах.
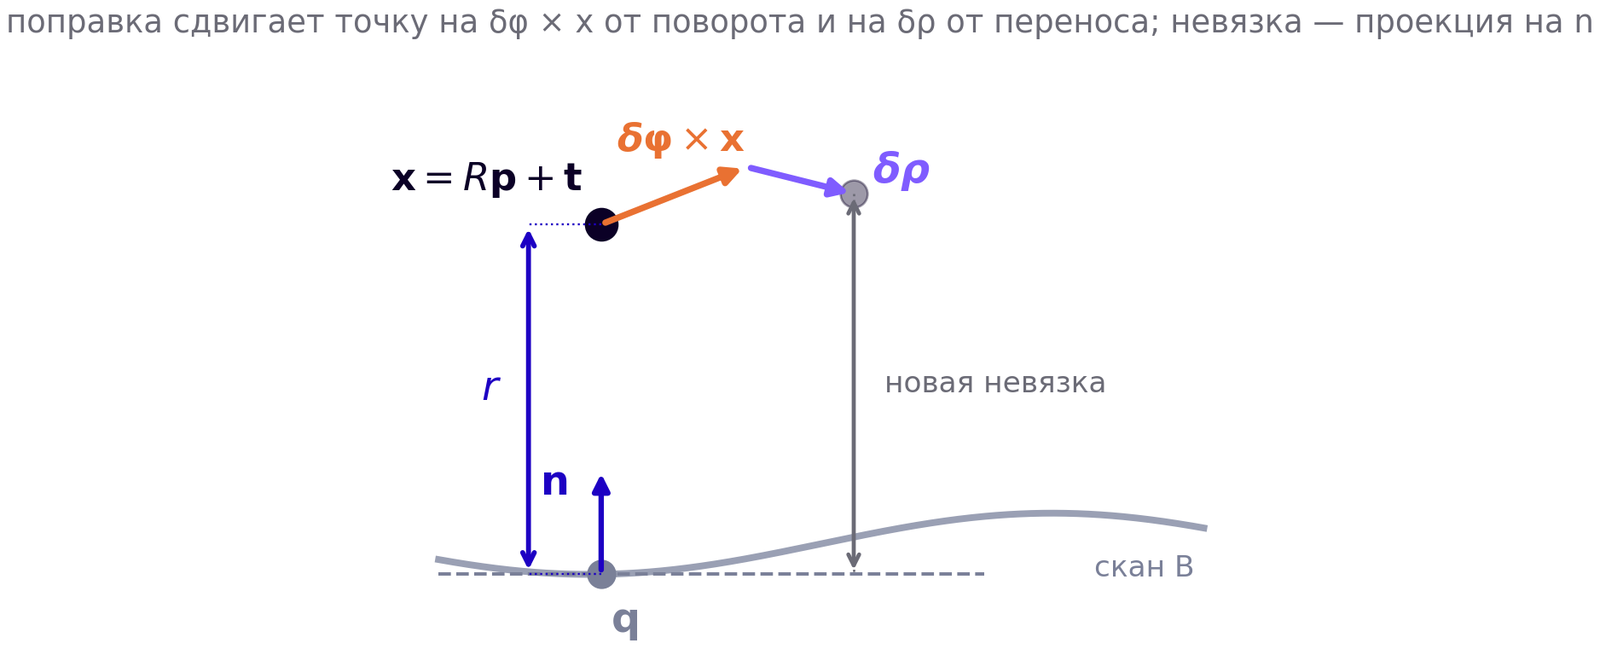
Что с невязкой сделает поправка? Маленький поворот сдвинет точку на $\boldsymbol{\delta\varphi}\times\mathbf{x}_i$ — это первый член разложения экспоненты. Маленький сдвиг добавит $\boldsymbol{\delta\rho}$. Точка переехала, и невязка стала другой:
$$ r_i(\boldsymbol\delta)=\mathbf{n}_i^\top\big(\mathbf{x}_i+\boldsymbol{\delta\varphi}\times\mathbf{x}_i+\boldsymbol{\delta\rho}-\mathbf{q}_i\big). $$
Обратите внимание на важное: изменилась не вся длина смещения, а только его проекция на нормаль. Составляющая вдоль поверхности невязку не меняет вовсе — ровно то, ради чего в § 2.4.2 бралось расстояние до плоскости.
2.6.3. Якобиан: одна строка из шести чисел
Раскроем скобки и приведём формулу к виду, где $\boldsymbol\delta$ стоит справа множителем.
Со сдвигом всё сразу: $\mathbf{n}^\top\boldsymbol{\delta\rho}$. С поворотом нужен один школьный приём. Выражение $\mathbf{n}\cdot(\boldsymbol{\delta\varphi}\times\mathbf{x})$ — смешанное произведение трёх векторов, а его можно переставлять по кругу, не меняя значения. Переставим так, чтобы $\boldsymbol{\delta\varphi}$ оказалась последней:
$$ r_i(\boldsymbol\delta)=r_i+(\mathbf{x}_i\times\mathbf{n}_i)^\top\boldsymbol{\delta\varphi}+\mathbf{n}_i^\top\boldsymbol{\delta\rho}. $$
Всё выстроилось: невязка равна текущей невязке плюс строка из шести чисел, умноженная на $\boldsymbol\delta$. Эти шесть чисел и есть якобиан одной точки:
$$ J_i=\big((\mathbf{x}_i\times\mathbf{n}_i)^\top,\;\mathbf{n}_i^\top\big), \qquad r_i(\boldsymbol\delta)\approx r_i+J_i\boldsymbol\delta . $$
Формально $J_i$ — производная невязки по приращению, взятая в нуле. Собрав такие строки по всем соответствиям в матрицу $J$, получаем $\mathbf{r}(\boldsymbol\delta)\approx\mathbf{r}+J\boldsymbol\delta$: строк столько, сколько точек, столбцов ровно шесть.
Мы только что оборвали ряд, а в § 2.5.9 было сказано, что обрывать нельзя. Противоречия нет, и разницу надо проговорить. Там ряд обрывался, когда мы строили поворот, и результат переставал быть поворотом. Здесь ряд обрывается в модели того, как изменится невязка, то есть в предсказании, по которому выбирается шаг. Сам шаг потом применяется точно, экспонентой. Если модель ошиблась, следующая итерация это исправит; если бы ошибся шаг, ошибка копилась бы навсегда. Линейная модель внутри, точное применение снаружи.
И практическая деталь: в $J$ входит $\mathbf{x}$, то есть текущее положение точки. Значит, пересчитывать якобиан надо на каждой итерации.
2.6.4. Один шаг: система шесть на шесть
Подставляем линейную модель в функционал и минимизируем по $\boldsymbol\delta$. Внутри теперь квадрат линейной функции, то есть обычные наименьшие квадраты, которые решаются приравниванием производной нулю:
$$ \min_{\boldsymbol\delta}\;\|\mathbf{r}+J\boldsymbol\delta\|^2 \qquad\Longrightarrow\qquad \big(J^\top J\big)\,\boldsymbol\delta=-J^\top\mathbf{r}. $$
Это система для квадратичной потери. Робастная, которую мы вводили в § 2.4.3, входит сюда весами: на каждой итерации считаем $w_i=\rho'(r_i)/r_i$ по текущим невязкам (при $r_i\to0$ берём предел, у Хьюбера это единица) и решаем
$$ \big(J^\top W J\big)\,\boldsymbol\delta=-J^\top W\mathbf{r}, \qquad W=\operatorname{diag}(w_1,\dots,w_N). $$
Эквивалентная и удобная в коде запись — домножить строки: $\tilde J_i=\sqrt{w_i}\,J_i$, $\tilde r_i=\sqrt{w_i}\,r_i$, и дальше обычные нормальные уравнения. Если веса опустить, робастная потеря не повлияет ни на что: получится обычный метод наименьших квадратов, и все рассуждения § 2.4.3 окажутся декоративными.
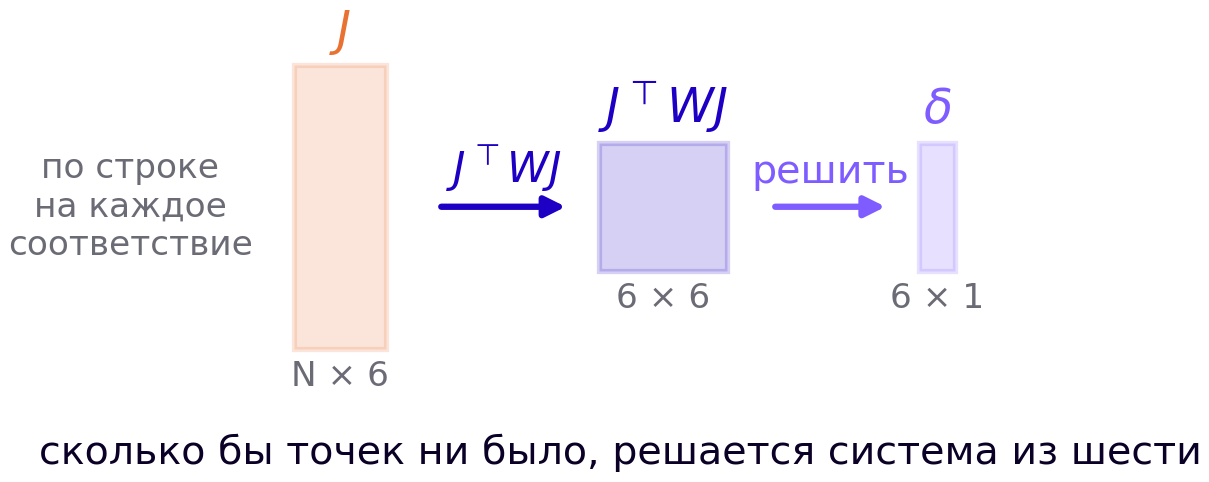
Посмотрите на формы, это главное. Сто тысяч уравнений свернулись в систему из шести. Это тот же фокус, что и у Кабша в § 2.3.4: там сто тысяч точек сворачивались в матрицу $3\times3$, здесь в $6\times6$. Данные входят только через сумму, поэтому память не растёт и после сборки системы точки больше не нужны.
Решаем систему и применяем $\boldsymbol\delta$ точно, по правилу из § 2.6.1. Система маленькая, так что способ решения роли не играет, но два практических вопроса он не закрывает.
Что делать при плохой обусловленности. Проверять её недостаточно, надо ещё как-то поступать. Обычный приём — добавить к диагонали малое $\lambda$, то есть решать $(J^\top WJ+\lambda I)\boldsymbol\delta=-J^\top W\mathbf{r}$: это подавляет движение вдоль слабо определённых направлений вместо того, чтобы раздувать его. Альтернатива — отбросить направления с малыми сингулярными числами явно.
Что делать, если шаг оказался плохим. Линейная модель верна только вблизи, и большой шаг может увеличить функционал или испортить соответствия. Поэтому после шага стоит сравнить стоимость до и после: если стало хуже, шаг уменьшают и повторяют. Это и есть damping, он же доверительная область, и на нём стоят все практические реализации. Утверждение «ошибку модели исправит следующая итерация» верно при достаточно малом шаге, а не само по себе.
Одна диагностика достаётся бесплатно, и она из § 2.3.6. Сингулярные числа матрицы $6\times6$ говорят, определена ли задача. Если облако плоское, ненаблюдаемыми оказываются три движения сразу: поворот вокруг нормали и два сдвига в самой плоскости. Значит, около нуля будут три сингулярных числа из шести — на идеально плоском наборе ровно три, на почти плоском они падают до $10^{-4}$ от старших. Это то самое почти-ядро, и проверять его стоит до того, как удивляться результату.
2.6.5. Цикл целиком
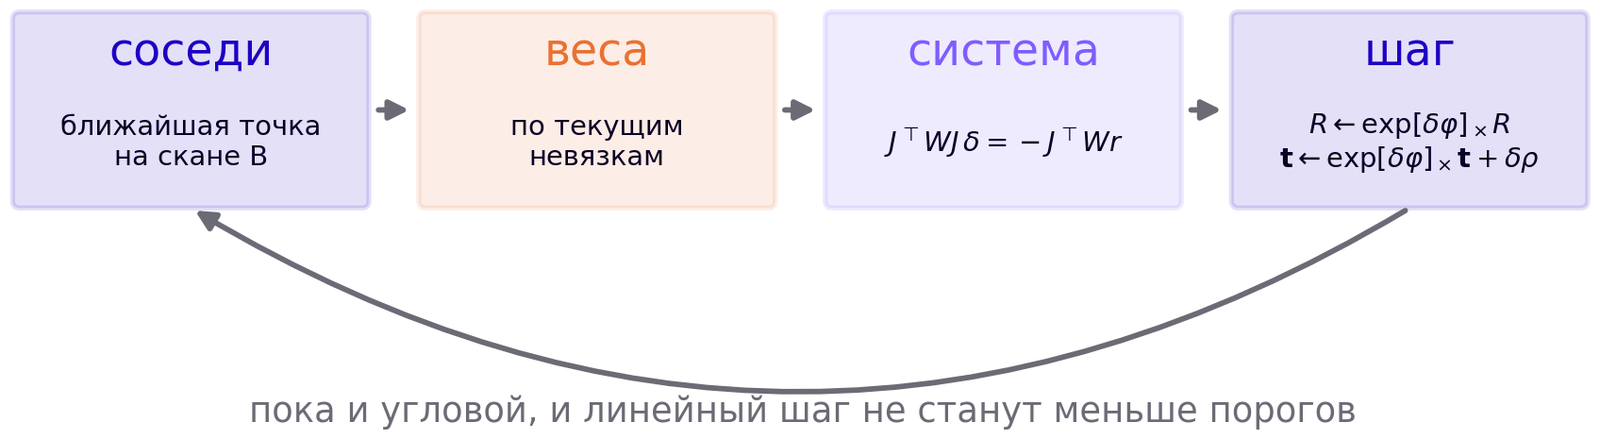
Собираем всё в один цикл, и каждый блок мы вывели отдельно и по нужде.
- Соседи. Для каждой точки первого скана ищем ближайшую точку второго и её нормаль. Самый дорогой шаг, делается деревом поиска. Появился из того, что пар никто не размечал (§ 2.4.1).
- Веса. Считаем их по текущим невязкам: чем больше невязка, тем меньше вес. Появились из того, что часть соседей назначена неверно (§ 2.4.3).
- Система. Собираем якобиан, сворачиваем в $6\times6$, решаем (§ 2.6.4).
- Шаг. Применяем поправку экспонентой. Появился из того, что прибавлять к матрице поворота нельзя (§ 2.5.1).
И снова соседи, потому что после сдвига они поменялись.
Останавливаемся, когда шаг перестаёт что-либо менять, и здесь нужны два порога, а не один. Чистый перенос даёт нулевой угловой шаг, поэтому проверять надо и $\|\boldsymbol{\delta\varphi}\|$ в градусах, и $\|\boldsymbol{\delta\rho}\|$ в миллиметрах: типично сотые доли градуса и сотые доли миллиметра. Полезно добавить третий критерий — относительное изменение функционала, — иначе алгоритм может долго топтаться при плохой обусловленности.
Остановка заслуживает отдельной строки, потому что одного порога тут не хватает. Порогов два: на угловую часть шага $\|\boldsymbol{\delta\varphi}\|$ и на линейную $\|\boldsymbol{\delta\rho}\|$, в градусах и в миллиметрах. Если следить только за углом, чистый перенос даст нулевой угловой шаг, и алгоритм остановится, не доехав.
Главное свойство схемы — модульность: менять можно любой блок по отдельности. Замените невязку с расстояния до плоскости на разность пикселей, и получите задачу лекции 3, а остальные три блока останутся теми же. Замените веса — получите другую робастность. Замените поиск соседей на заранее известные соответствия и невязку до плоскости на «точка минус точка» — вернётесь к Кабшу. Одной фиксации соответствий для этого мало: проекторы на нормали никуда не денутся, см. § 2.4.3.
2.6.6. Что получается на нашей детали
Это не рисунок, а прогон, и условия у него надо назвать честно, иначе из графика прочитают больше, чем в нём есть.
Второе облако получено из того же набора точек: я взял скан детали, развернул его на $6°$, отодвинул на 4 мм и добавил шум 0,3 мм. Значит, перекрытие полное, выбросов нет, и робастные веса в этом прогоне не работают. Это тест локальной сходимости линеаризации, а не тест робастного совмещения двух независимо снятых частичных сканов, с которых начиналась глава. 40 тысяч точек, невязка до касательной плоскости, система $6\times6$, применение экспонентой.
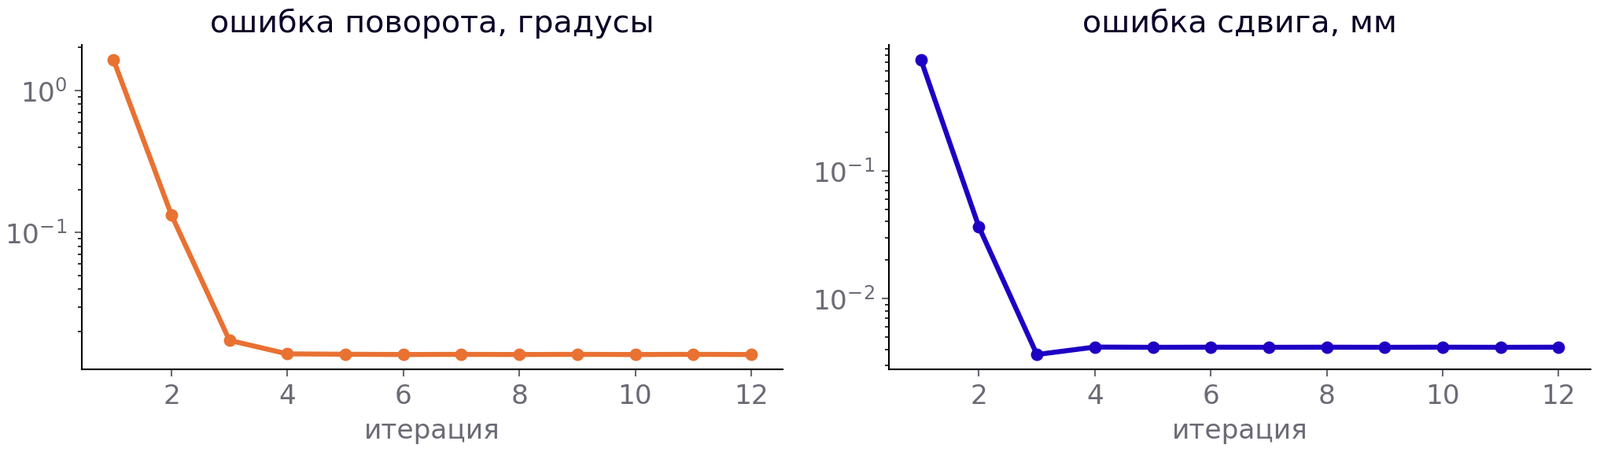
За 12 итераций ошибка поворота упала до $0{,}014°$, ошибка сдвига до $0{,}004$ мм. Обратите внимание на масштаб оси: первые итерации дают по порядку каждая, и это признак того, что линейная модель хорошо описывает задачу вблизи решения.
Дальше кривая выходит на полку, и продолжать итерации бессмысленно. Полку правильно читать как масштаб остаточной ошибки в этом опыте: сюда вносят вклад и шум измерений, и смещение оценки, и неточность нормалей. Один прогон не доказывает, что это статистический предел точности сенсора; он показывает, что дальше уменьшать шаг нечем.
И честная оговорка. Всё это работает только потому, что мы стартовали близко. При большом начальном развороте ближайший сосед назначается неверно, и итерация уходит в локальный минимум: сходится уверенно и не туда, причём невязка при этом мала и ни на что не жалуется. Поэтому Кабш по нескольким размеченным парам не выброшен — он даёт начальное приближение. Грубое совмещение по пяти точкам, потом точное по ста тысячам. Так устроены все реальные конвейеры.
2.6.7. Куда это ведёт
Мы решили задачу для двух сканов и шести неизвестных. Дальше всё растёт, но схема остаётся.
Сканов не два. Четырнадцать проходов дают тринадцать попарных совмещений, и если складывать их по цепочке, ошибка накопится: последний скан не сойдётся с первым. Правильно искать все позы сразу, из одной большой системы; неизвестных становится шесть на число сканов.
Одна деталь тут обязательна. Функционал зависит только от взаимных положений, поэтому сдвинув и повернув всю конструкцию целиком, мы его не изменим: у задачи остаётся шесть ненаблюдаемых направлений, и система вырождена ровно на них. Лечится это фиксацией системы отсчёта — обычно первую позу закрепляют. Без этого решатель будет спотыкаться о вырожденность, происхождение которой неочевидно.
Переносится каркас, а не строка. Замените расстояние до плоскости на разность пикселей между спроецированной точкой и тем, что видно на снимке, и получите задачу восстановления по фотографиям. Но переносится именно схема «невязка, якобиан, робастная линейная подзадача, точное обновление», а не механическая замена одного блока: в фотограмметрии соответствия берутся из треков наблюдений, а не пересчётом ближайшего соседа, и неизвестными становятся ещё и сами трёхмерные точки. Это лекция 3 и дальше.
Разреженность. Когда неизвестных тысячи, матрица системы огромна, но почти пуста: каждая точка видна лишь с нескольких камер. Эксплуатация этой разреженности превращает неподъёмную задачу в считаемую за секунды. Так устроен bundle adjustment (Triggs et al., 2000), на котором стоит вся фотограмметрия.
И для ориентировки в литературе: всё, что мы здесь делали руками, в современных библиотеках называется работой с группами Ли (Solà et al., 2018). Приращение в касательном пространстве, экспонента, логарифм — это стандартный интерфейс в ceres, g2o, GTSAM, Sophus.
2.7. Что мы держали запертым
Всю главу мы работали с матрицей $4\times4$, у которой последняя строка равна $(0,0,0,1)$. Именно из-за этого запора деление никогда не срабатывало, и мы получили шесть чисел, которые можно проверить измерением.
Весь остальной курс — это отпирание той же матрицы, по одной степени свободы за раз. И каждая отпертая степень свободы ровно соответствует тому, чего не различает сенсор.
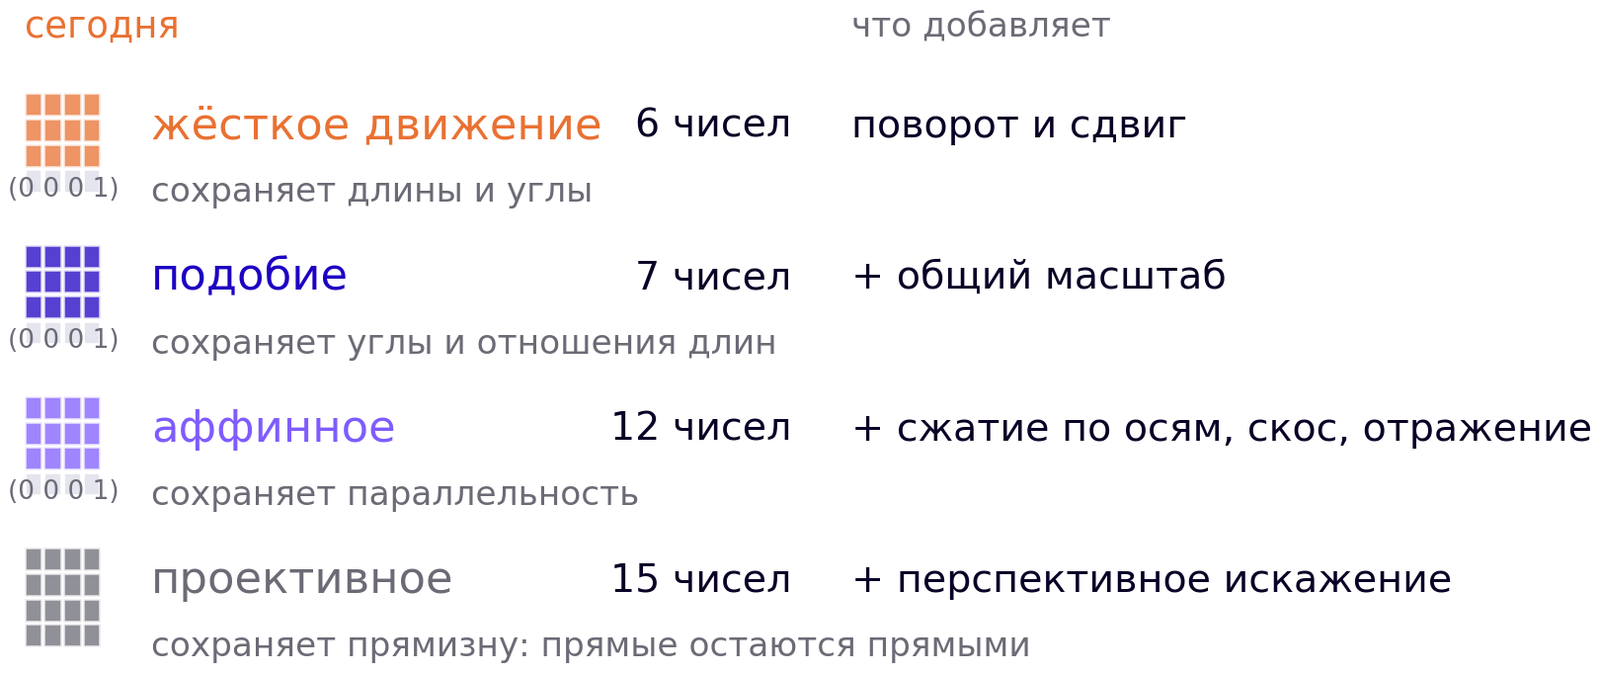
| Класс | Добавляет | Чисел | Сохраняет |
|---|---|---|---|
| жёсткое движение | поворот и сдвиг | 6 | длины и углы |
| подобие | общий масштаб | 7 | углы и отношения длин |
| аффинное | сжатие по осям, скос, отражение | 12 | параллельность |
| проективное | перспективное искажение | 15 | прямизну |
Читать таблицу надо снизу вверх как сужение: каждый следующий класс получается из предыдущего запиранием части клеток. И запирание — это всегда дополнительная информация о мире, которую надо откуда-то взять.
Пример, который стоит запомнить. Подобие добавляет масштаб, и именно его не хватает, когда сцену восстанавливают по фотографиям одной камерой: увеличенная вдвое сцена, снятая вдвое дальше, даёт ровно тот же снимок. Масштаб нам в этой главе дал прибор, а не математика.
2.8. Та же невязка, но в пикселях
Следующая лекция открывается не новым аппаратом, а той же схемой с другой невязкой.
Здесь невязка — расстояние между точкой и поверхностью, в миллиметрах: обе величины трёхмерные, обе измерены прибором. На следующей лекции точка трёхмерная, а измерение двумерное, это пиксель на снимке. Чтобы их сравнить, точку надо спроецировать: применить наше преобразование, потом матрицу камеры, потом поделить на глубину.
$$ \mathbf{r}=\pi\big(K\,[R\,|\,\mathbf{t}]\,\mathbf{X}\big)-\mathbf{u}. $$
Здесь $\mathbf{X}$ — точка в пространстве в однородных координатах; $[R\,|\,\mathbf{t}]$ — наше сегодняшнее преобразование, переводящее точку в систему камеры; $K$ — внутренние параметры камеры, фокусное расстояние и центр снимка в пикселях; $\pi$ — деление на третью координату, то самое деление из § 2.2.4; $\mathbf{u}$ — пиксель, в котором точку реально видно.
Внутри формулы стоит ровно та матрица, которую мы собрали в § 2.2.3. Она никуда не делась, вокруг неё просто появилась проекция.
Два следствия прилагаются, и оба стоит сформулировать аккуратно.
Первое: появляется деление на глубину. При этом $[R\,|\,\mathbf{t}]$ остаётся жёстким движением, у внешних параметров камеры ничего не отпирается. Таблица § 2.7 — про класс преобразований, связывающих две реконструкции одной сцены, и вниз по ней мы съезжаем не из-за деления, а из-за того, что часть информации о сцене перестаёт быть наблюдаемой.
Второе: глубина неизвестна, её приходится оценивать вместе с позами. Отсюда и берётся масштабная неопределённость — по снимкам одной камеры сцена восстанавливается с точностью до подобия, то есть ровно на одну строчку таблицы ниже жёсткого движения.
Что до сегодняшнего аппарата, он остаётся весь: цикл из четырёх блоков, приращение в касательном пространстве, экспонента, сингулярное разложение. Меняется одна строка — чем считается невязка.
2.9. Шпаргалка
Запись движения.
$$ T=\begin{pmatrix} R & \mathbf{t}\\ \mathbf{0}^\top & 1\end{pmatrix},\qquad T_2T_1=\begin{pmatrix} R_2R_1 & R_2\mathbf{t}_1+\mathbf{t}_2\\ \mathbf{0}^\top & 1\end{pmatrix},\qquad T^{-1}=\begin{pmatrix} R^\top & -R^\top\mathbf{t}\\ \mathbf{0}^\top & 1\end{pmatrix}. $$
Обратный перенос $-R^\top\mathbf{t}$, а не $-\mathbf{t}$. T.T вместо обращения ломает последнюю строку и не падает.
Проверка матрицы, три строки кода. $\|R^\top R-I\|<\varepsilon$; $\det R>0$; последняя строка равна $(0,0,0,1)$. Определитель около $-1$ — отражение, ищите одиночный флип оси. $R^\top R\neq I$ — потерялось транспонирование или вкрался масштаб. Сломалась последняя строка — транспонировали всю $T$.
Индексы. $T_{13}=T_{12}T_{23}$, $T_{21}=T_{12}^{-1}$; внутренние индексы сокращаются. Держите направление в имени переменной.
Кабш, совмещение по парам.
$$ \tilde{\mathbf{p}}_i=\mathbf{p}_i-\bar{\mathbf{p}},\quad \tilde{\mathbf{q}}_i=\mathbf{q}_i-\bar{\mathbf{q}},\quad H=\sum_i\tilde{\mathbf{q}}_i\tilde{\mathbf{p}}_i^\top=U\Sigma V^\top, $$ $$ R=U\operatorname{diag}\big(1,1,\det(UV^\top)\big)V^\top,\qquad \mathbf{t}=\bar{\mathbf{q}}-R\bar{\mathbf{p}}. $$
Проверка знака обязательна. Плоское расположение отмеченных точек не мешает: лишь бы они не лежали на одной прямой и были разнесены пошире.
Вращение: что чем. Применять — матрицей. Хранить и интерполировать — кватернионом, $q=(\cos(\theta/2),\sin(\theta/2)\mathbf{n})$, чинится делением на длину, $q$ и $-q$ — один поворот. Оптимизировать — приращением $\boldsymbol\omega$ через $\exp$. Показывать человеку — углами Эйлера.
$$ R=\exp[\boldsymbol\omega]_\times=I+\sin\theta\,[\mathbf{n}]_\times+(1-\cos\theta)\,[\mathbf{n}]_\times^2, \qquad \boldsymbol\omega=\theta\mathbf{n}. $$
Обрывать ряд при построении поворота нельзя: при $5°$ отклонение от ортогональности уже $10^{-2}$.
Итерация ICP. Невязка до касательной плоскости, робастная потеря, соседи пересчитываются каждый шаг.
$$ \mathbf{x}_i=R\mathbf{p}_i+\mathbf{t},\qquad r_i=\mathbf{n}_i^\top(\mathbf{x}_i-\mathbf{q}_i),\qquad J_i=\big((\mathbf{x}_i\times\mathbf{n}_i)^\top,\;\mathbf{n}_i^\top\big), $$ $$ w_i=\rho'(r_i)/r_i,\qquad \big(J^\top WJ+\lambda I\big)\boldsymbol\delta=-J^\top W\mathbf{r},\qquad W=\operatorname{diag}(w_i), $$ $$ R\leftarrow\exp[\boldsymbol{\delta\varphi}]_\times R,\qquad \mathbf{t}\leftarrow\exp[\boldsymbol{\delta\varphi}]_\times\mathbf{t}+\boldsymbol{\delta\rho}. $$
Веса обязательны: без $W$ робастная потеря ни на что не влияет. Обновлять надо оба, и $R$, и $\mathbf{t}$. Останов — по двум порогам сразу, на $\|\boldsymbol{\delta\varphi}\|$ и на $\|\boldsymbol{\delta\rho}\|$: чистый перенос даёт нулевой угловой шаг. Если после шага функционал вырос, шаг уменьшают.
Обрывать ряд в модели невязки можно, в самом шаге нельзя. Сингулярные числа $J^\top WJ$ скажут, определена ли задача; малое $\lambda$ на диагонали подавляет слабые направления.
К семинару. Реализовать Кабша с проверкой знака и прогнать ICP на выданных сканах. Всё нужное — в формулах выше.
Литература
Учебники
- R. Hartley, A. Zisserman. Multiple View Geometry in Computer Vision, 2nd ed., 2004 — приложение о параметризациях вращения.
- J. Solà, J. Deray, D. Atchuthan. A micro Lie theory for state estimation in robotics, 2018 — самое короткое введение в то, чем мы занимались в § 2.6.1.
Совмещение по парам точек
- W. Kabsch. A solution for the best rotation to relate two sets of vectors. Acta Cryst. A32, 1976. Поправка на знак определителя — в продолжении 1978 года.
- K. S. Arun, T. S. Huang, S. D. Blostein. Least-Squares Fitting of Two 3-D Point Sets. IEEE PAMI, 1987 — независимый вывод того же ответа.
- S. Umeyama. Least-squares estimation of transformation parameters between two point patterns. IEEE PAMI, 1991 — разбор вырожденных случаев и масштаба.
Итеративное совмещение
- P. Besl, N. McKay. A Method for Registration of 3-D Shapes. IEEE PAMI, 1992 — ICP с невязкой «точка минус точка».
- Y. Chen, G. Medioni. Object modelling by registration of multiple range images. Image and Vision Computing, 1992 — невязка до касательной плоскости, та, что в § 2.4.2.
- S. Rusinkiewicz, M. Levoy. Efficient Variants of the ICP Algorithm. 3DIM, 2001 — какой блок кольца на что менять.
- B. Triggs, P. McLauchlan, R. Hartley, A. Fitzgibbon. Bundle Adjustment — A Modern Synthesis. Vision Algorithms, 2000 — та же схема, когда неизвестных тысячи.
Представления вращения и робастность
- K. Shoemake. Animating rotation with quaternion curves. SIGGRAPH, 1985 — откуда взялся slerp.
- F. S. Grassia. Practical Parameterization of Rotations Using the Exponential Map. Journal of Graphics Tools, 1998 — численные ловушки экспоненты и логарифма при нуле и при $\pi$.
- P. J. Huber. Robust Estimation of a Location Parameter. Ann. Math. Statist., 1964 — та самая потеря.
- Robust kernels в Open3D — как веса из § 2.4.3 выглядят в коде.